Nvidia Araştırması: Yapay Zeka Ajanlarında Asıl Kahraman “Harness”

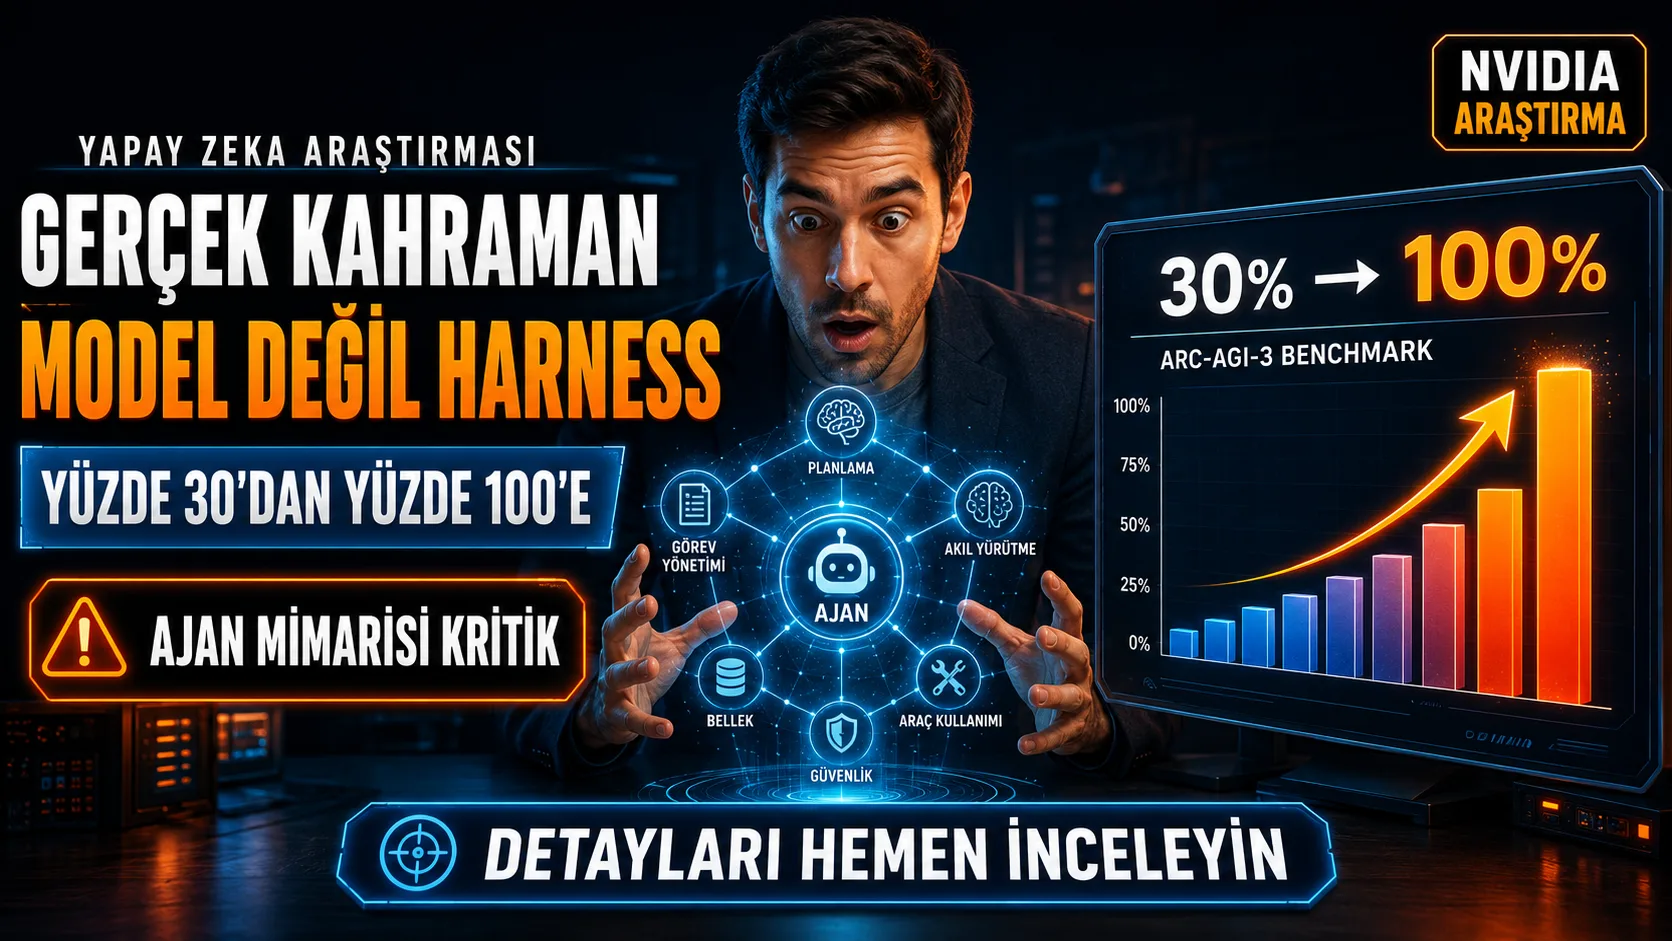
NVIDIA, 21 Ağustos 2026 tarihinde AVO ajan mimarisinin ARC-AGI-3 açık test kümesinde 100 RHAE puanı aldığını duyurdu. Yaklaşık 30 puanlık model değerlendirmesiyle karşılaştırma, harness tasarımının etkisini tek başına ölçen kontrollü bir deney değildir.
Nvidia’nın Araştırması Ne Buldu?
Teknik yazının yazarları Terry Chen, Yeyin Zhu, Zhifan Ye, Jean-Francois Puget ve Humphrey Shi. AVO, Claude Opus 5 ile açık kümedeki 25 ortamın 183 seviyesini tamamladı; özel yarışma kümeleri bu sonuca dahil değil.
RHAE, görev tamamlama ile insanlara göre eylem verimliliğini birlikte değerlendirir. NVIDIA, karşılaştırılan kurulumların akıl yürütme ayarı ve ajan sistemi açısından farklı olduğunu belirtiyor; farkın tamamını bellek veya denetleyiciye bağlayamayız.
“Harness” Kavramı Tam Olarak Neyi İfade Ediyor?
Harness; bağlamı, araç çağrılarını, çalışma durumunu ve hata sonrası devam etmeyi yöneten yazılım katmanıdır. Model seçerken bu katmanın izinlerini, testlerini ve maliyet sınırlarını da değerlendirmek gerekir.
Bellek Yönetimi
Ajanın önceki adımları hatırlaması, tekrar eden hataları fark edip döngüden çıkabilmesi için kritik. Zayıf bellek yönetimi, uzun görevlerde ajanın “unutkanlaşmasına” ve baştan başlamasına yol açıyor.
Denetleyici (Supervisor) Mekanizması
Araştırmada öne çıkan bir diğer bileşen, ajanı verimsiz bir yola girdiğinde fark edip yönlendiren bir denetleyici katmanıydı. Bu mekanizma olmadan ajan, çözümsüz bir stratejide saatlerce takılı kalabiliyor.
Harness Maliyeti Nasıl Değiştiriyor?
Databricks’in kendi kod tabanındaki değerlendirmesinde, aynı model ve düşünme ayarıyla bazı harness çiftlerinde görev maliyeti iki kattan fazla farklılaştı; kalite benzer kaldı. Bu, her modelde ve her görevde sabit bir maliyet çarpanı bulunduğu anlamına gelmez.
| Değerlendirme | Sonuç | Sınır |
|---|---|---|
| ARC Prize model değerlendirmesi | Yaklaşık 30 RHAE | Farklı kurulum |
| NVIDIA AVO | 100 RHAE | Yalnızca açık test kümesi |
| Databricks kod görevleri | Bazı maliyetlerde 2 katı aşan fark | Ayrı veri kümesi ve deney |
Bu Gelişme Türkiye’deki Şirketleri Nasıl Etkiler?
Türkiye’de yapay zekâ ürünü geliştiren ekipler için uygulanabilir yaklaşım, model ve harness seçeneklerini kendi görev örneklerinde birlikte ölçmektir. Başarı oranını, tamamlanan görev başına maliyeti ve gecikmeyi aynı tabloda izleyin. Bir benchmark sonucu müşteri hizmetlerinde veya üretim otomasyonunda aynı kazancı garanti etmez.
Bu durum aynı zamanda bütçe planlaması açısından da önemli bir ayrım getiriyor. Bir şirket API maliyetlerini düşürmek için daha ucuz bir modele geçtiğinde, harness katmanını da buna göre güçlendirmezse performans kaybı yaşayabilir. Tersine, sınırlı bütçeyle çalışan küçük ekipler, en pahalı modeli almak yerine mevcut modellerinin harness’ini iyileştirerek benzer bir sonuca daha düşük maliyetle ulaşabilir. Bu yaklaşım özellikle erken aşama girişimler ve iç araçlarını kendi geliştiren şirketler için pratik bir avantaj sunuyor.
Ajan Mimarisi Kurarken Kontrol Edilmesi Gerekenler
- Ajan, önceki adımları ve hataları hatırlayabiliyor mu?
- Verimsiz bir yola girdiğinde bunu fark edip yön değiştirebiliyor mu?
- Araç çağırma (tool calling) hataları düzgün şekilde ele alınıyor mu?
- Uzun görevlerde bağlam penceresi taşması engelleniyor mu?
- Maliyet ve gecikme, harness katmanındaki gereksiz adımlar yüzünden şişiyor mu?
Bu kontrol listesi bir tasarım değerlendirmesidir. Hangi değişikliğin işe yaradığını görmek için temsilî görevleri önce sabitleyin, sonra bir bileşeni değiştirerek yeniden ölçün; pahalı bir modelden daha iyi sonuç alınacağı varsayımıyla karar vermeyin.
Yaygın Hatalar ve Araştırmanın Sınırları
Bulguları değerlendirirken dikkat edilmesi gereken birkaç nokta var. Öncelikle test, kontrollü bir kıyaslama ortamında yapıldı; gerçek dünyadaki üretim sistemlerinde ağ gecikmesi, kullanıcı davranışı ve veri kalitesi gibi ek değişkenler sonucu etkileyebilir. İkinci olarak, “harness’i iyileştirmek” tek başına sihirli bir çözüm değildir; yetersiz bir modelin üzerine ne kadar iyi bir harness eklenirse eklensin, temel akıl yürütme sınırlamaları tamamen ortadan kalkmaz. Üçüncüsü, karmaşık bir harness kurulumu geliştirme ve bakım maliyetini artırabilir; bu nedenle her ekip, kendi kullanım senaryosu için maliyet-fayda dengesini ayrıca değerlendirmelidir.
Yine de araştırmanın ortaya koyduğu genel eğilim net: model seçimi tek başına yeterli bir strateji değil. Ajan tasarımına bütünsel yaklaşmayan ekipler, elde ettikleri modelin gerçek potansiyelinin oldukça altında sonuçlarla karşılaşabilir.
Sonuç
Nvidia’nın araştırması, yapay zeka ajanlarında “hangi model” sorusunun tek belirleyici olmadığını sayısal verilerle ortaya koyuyor. Aynı model, farklı bir yazılım mimarisiyle çok daha güvenilir sonuçlar verebiliyor. Bu da hem geliştiriciler hem de yapay zeka araçlarını değerlendiren şirketler için model seçiminin ötesinde, ajan mimarisine de yatırım yapmanın gerekliliğini gösteriyor.
Sık Sorulan Sorular
Harness nedir, model ile aynı şey mi?
Hayır. Model, ajanın “beyni” iken harness; bellek yönetimi, araç kullanımı, denetleyici mekanizmalar ve çalışma zamanı kurallarından oluşan destekleyici yazılım katmanıdır.
ARC-AGI-3 testi ne ölçüyor?
ARC-AGI-3, yapay zeka sistemlerinin akıl yürütme ve genelleme becerisini ölçmek için tasarlanmış, bulmaca tarzı görevlerden oluşan bir kıyaslama (benchmark) setidir.
Bu bulgular tüm yapay zeka modelleri için geçerli mi?
Hayır. Benchmark sonucu farklı görevlerde aynı başarıyı garanti etmez; model ile ajan sistemini birlikte sınamak gerekir.
Şirketler bu bilgiyi nasıl kullanabilir?
Yapay zeka ürünü geliştiren ekipler, bütçelerinin bir kısmını yalnızca model yükseltmesine değil, bellek yönetimi ve hata kontrolü gibi harness bileşenlerine ayırarak performans artışı hedefleyebilir.
Harness optimizasyonu maliyeti artırır mı?
Bazı Databricks kod görevlerinde benzer kaliteyle iki kattan fazla maliyet farkı görülmesi, harness seçiminin bütçeyi etkileyebileceğini gösteriyor. Kendi kullanımınızda tamamlanan görev başına toplam maliyeti ölçün.
Kaynaklar ve İleri Okuma
- NVIDIA: AVO mimarisi ve ARC-AGI-3 sonuçları
- Databricks: Kod ajanlarını kendi kod tabanında değerlendirme
İlgili Yazılar