Yapay zeka çıkarımı nedir? Yapay zeka çıkarımı (inference), önceden eğitilmiş bir modelin yeni bir istekte verilen girdilere bakarak tahmin, sınıflandırma veya metin üretimi gibi bir çıktı oluşturması sürecidir. Bir sohbet botuna soru sorduğunuzda, bir uygulamanın fotoğrafınızdaki nesneyi tanıdığında ya da bir öneri sisteminin size ürün önerdiğinde arka planda çalışan şey tam olarak budur: standart çıkarımda ağırlıklar güncellenmeden modelin öğrendiği örüntüler kullanılıyor.
Yapay Zeka Çıkarımı Nedir, Eğitimden Farkı Ne?
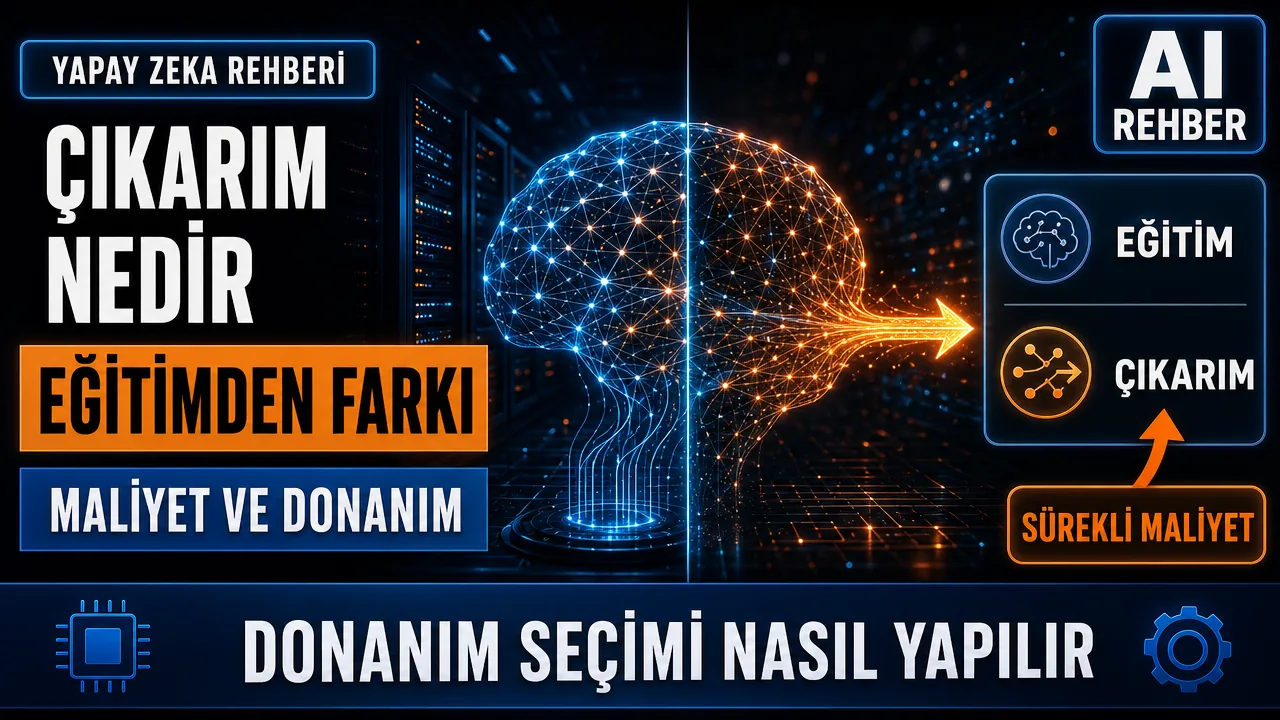
Yapay zeka sistemlerinin hayat döngüsü iki ana aşamadan oluşur: eğitim ve çıkarım. Eğitim aşamasında model, büyük miktarda veriyle beslenir; doğru cevaba ne kadar yaklaştığına bağlı olarak iç parametrelerini (ağırlıklarını) tekrar tekrar günceller. Bu süreç genellikle bir kez veya belirli aralıklarla tekrarlanan, yoğun ama sınırlı süreli bir maliyet kalemidir. Çıkarım ise modelin eğitimi tamamlandıktan sonra, üretim ortamında gerçek kullanıcı isteklerine yanıt verdiği sürekli çalışan aşamadır.
Neden Bu Ayrım Önemli?
Eğitim ile çıkarım bütçesinin oranı modele ve kullanım hacmine bağlıdır. Eğitim çoğu üründe tekrarlanır; düşük trafikli uygulamada çıkarım toplamı daha küçük kalabilir. Bir sektörün bütçesinin çoğunun çıkarıma geçtiği iddiası için tanımlı örneklem ve kaynak gerekir.
| Özellik | Eğitim (Training) | Çıkarım (Inference) |
|---|---|---|
| Amaç | Modelin örneklerden öğrenmesi | Öğrenilenin yeni veriye uygulanması |
| Sıklık | Bir kez veya periyodik | Her kullanıcı isteğinde sürekli |
| Maliyet Yapısı | Yüksek, tek seferlik yatırım | Düşük-orta, ama sürekli işletme gideri |
| Tipik Donanım | Çok sayıda yüksek bellekli GPU kümesi | Çıkarıma özel çip veya optimize edilmiş GPU |
| Gecikme Hassasiyeti | Düşük öncelik | Yüksek öncelik (kullanıcı bekliyor) |
Yapay Zeka Çıkarımı Nasıl Çalışır?
Bir çıkarım isteği geldiğinde model, girdiyi (metin, görsel, ses) sayısal bir temsile dönüştürür, bu temsili katman katman işler ve sonunda bir çıktı üretir. Büyük dil modellerinde bu süreç genellikle token adı verilen küçük metin parçalarının sırayla üretilmesiyle ilerler; her yeni token, bir öncekine bağlı olarak hesaplanır. Bu sıralı yapı, çıkarım donanımının neden farklı tasarlandığını da açıklıyor: model ne kadar hızlı ve ucuz bir şekilde art arda token üretebiliyorsa, kullanıcı deneyimi o kadar akıcı olur.
Çıkarım Maliyetini Etkileyen Faktörler
- Model boyutu: Daha büyük modeller genellikle daha fazla hesaplama gücü ve bellek gerektirir.
- Bağlam uzunluğu: Modele verilen girdi ne kadar uzunsa, işlem yükü o kadar artar.
- Eşzamanlı istek sayısı: Aynı anda kaç kullanıcının hizmet aldığı, gereken sunucu kapasitesini belirler.
- Donanım verimliliği: Bellek bant genişliği ve çip mimarisi, aynı model için çıkarım maliyetini önemli ölçüde değiştirebilir.
Çıkarım İçin Kullanılan Donanım Türleri
Piyasada hem eğitim hem çıkarım için kullanılabilen genel amaçlı GPU’lar bulunsa da, sektör giderek çıkarıma özel çipler geliştirmeye yöneliyor. Bu çipler, sıralı token üretimi için optimize edilmiş bellek mimarileri veya düşük güç tüketimiyle yüksek verim hedefleyen tasarımlar sunuyor. Donanım üreticilerinin veri merkezi çipi yarışını hızlandırmasının temel nedenlerinden biri de bu artan çıkarım talebi; nitekim Qualcomm ile Amazon arasındaki çip anlaşması da doğrudan bu çıkarım donanımı ihtiyacına dayanıyor.
Küçük cihazlarda çalışan modeller için ise bambaşka bir yaklaşım gerekiyor: Edge AI olarak adlandırılan bu yöntemde çıkarım, uzak bir veri merkezine değil doğrudan telefon veya IoT cihazı üzerinde gerçekleştiriliyor; bu da gecikmeyi azaltırken veri gizliliğini de artırıyor.
Yapay Zeka Çıkarımını Değerlendirirken Kontrol Listesi
Bir yapay zeka ürünü tasarlarken veya satın alırken çıkarım tarafını değerlendirmek için şu noktaları kontrol edebilirsiniz:
- Beklenen eşzamanlı kullanıcı sayısına göre çıkarım maliyeti hesaplandı mı?
- Model, gecikme gereksinimlerinizi (örneğin gerçek zamanlı sohbet) karşılayacak hızda mı?
- Bulut sağlayıcısının sunduğu çıkarıma özel donanım seçenekleri değerlendirildi mi?
- Model boyutu küçültme (quantization, distillation gibi) tekniklerinin maliyeti düşürüp düşüremeyeceği incelendi mi?
- Artan kullanım durumunda maliyetin nasıl ölçekleneceğine dair bir tahmin yapıldı mı?
Yaygın Yanlış Anlamalar
Çıkarımla ilgili en sık karşılaşılan yanlış anlama, modelin her kullanıcı isteğinde “yeniden öğrendiği” düşüncesi. Oysa çıkarım aşamasında model parametreleri sabittir; model yalnızca önceden öğrendiği örüntüleri yeni girdiye uygular. Bir diğer yanlış anlama ise çıkarım maliyetinin ihmal edilebilir olduğu varsayımı; oysa kullanıcı sayısı arttıkça bu maliyet, başlangıçtaki eğitim maliyetini kolaylıkla aşabilir.
Şirketler Çıkarım Maliyetini Nasıl Düşürüyor?
2026 itibarıyla yapay zeka altyapısı sağlayan şirketlerin büyük kısmı, ürünlerini artık eğitim performansından çok çıkarım verimliliğine göre konumlandırıyor. Bunun somut örneklerinden biri, çip üreticilerinin yüksek bant genişlikli bellek yerine daha ucuz ve bol miktarda bellek kullanan mimarilere yönelmesi; bu sayede tek bir kartta çok daha fazla model parametresi tutulabiliyor ve sunucu başına daha fazla kullanıcıya hizmet verilebiliyor. Bulut sağlayıcıları da benzer şekilde, çıkarım isteklerini akıllıca gruplamak (dynamic batching), sık tekrarlanan istekleri önbelleklemek ve trafiğe göre otomatik ölçeklenen sunucu havuzları kurmak gibi yöntemlerle maliyeti aşağı çekmeye çalışıyor.
Yazılım tarafında ise model küçültme teknikleri öne çıkıyor. Quantization, modelin sayısal hassasiyetini düşürerek (örneğin 32 bit yerine 8 bit) hem bellek kullanımını hem de hesaplama süresini azaltıyor; distillation ise büyük bir modelin bilgisini daha küçük bir modele “damıtarak” benzer kalitede ama çok daha ucuz çalışan bir sürüm elde etmeyi hedefliyor. Bu tekniklerin hiçbiri tek başına sihirli bir çözüm değil; genellikle birkaçı bir arada uygulanarak maliyet ve kalite arasında kabul edilebilir bir denge kuruluyor.
Sonuç
Yapay zeka çıkarımı, bir modelin laboratuvardan gerçek kullanıcıya ulaştığı aşamayı temsil ediyor ve günümüzde yapay zeka ekonomisinin en büyük operasyonel maliyet kalemlerinden birini oluşturuyor. Eğitim yeniden eğitim, fine-tuning ve değerlendirmelerle tekrarlanabilen bir maliyetken, çıkarım sürekli optimize edilmesi gereken bir işletme sürecidir. Bu ayrımı anlamak, hem yapay zeka ürünü geliştirenler hem de bu araçları kurumsal düzeyde kullanmayı planlayanlar için doğru donanım ve maliyet kararları almanın ilk adımı.
Sık Sorulan Sorular
Yapay zeka çıkarımı nedir, basitçe nasıl açıklanır?
Yapay zeka çıkarımı, eğitilmiş bir modelin yeni bir girdiye bakarak tahmin veya çıktı üretmesi sürecidir; modelin “öğrenmeyi bitirip bilgiyi kullanmaya başladığı” aşama olarak düşünülebilir.
Çıkarım maliyeti neden eğitim maliyetinden daha önemli hale geliyor?
Eğitim periyodik olarak da tekrarlanabilirken, çıkarım her kullanıcı isteğinde tekrarlanır; kullanıcı sayısı arttıkça toplam çıkarım maliyeti zamanla eğitim maliyetini aşabilir.
Çıkarım için özel çip kullanmak gerekli mi?
Zorunlu değil, ancak yüksek trafikli uygulamalarda çıkarıma özel optimize edilmiş donanım, genel amaçlı GPU’lara kıyasla belirgin maliyet ve hız avantajı sağlayabilir.
Edge AI ile bulut tabanlı çıkarım arasındaki fark nedir?
Edge AI’da çıkarım doğrudan cihaz üzerinde gerçekleşirken, bulut tabanlı çıkarımda istek uzak bir sunucuya gönderilir; seçim genellikle gecikme, gizlilik ve maliyet dengesine göre yapılır.
Bir modelin çıkarım hızını nasıl artırabilirim?
Model boyutunu küçültme teknikleri (quantization, distillation), önbellekleme, isteklerin toplu (batch) işlenmesi ve çıkarıma özel donanım kullanımı, hız artışı sağlayan yaygın yöntemler arasında yer alıyor.
Otomatik ölçekleme sağlayıcının ve uygulamanın yapılandırmasına bağlıdır. Batching toplam verimi artırırken tek kullanıcının beklemesini uzatabilir. Niceleme her donanımda hız kazandırmaz; aynı kalite, bağlam ve eşzamanlılıkta ilk token süresi, token/s ve toplam maliyeti ölçün. Yerel çıkarım da uygulamanın telemetri veya bulut araçlarını kendiliğinden kapatmaz.