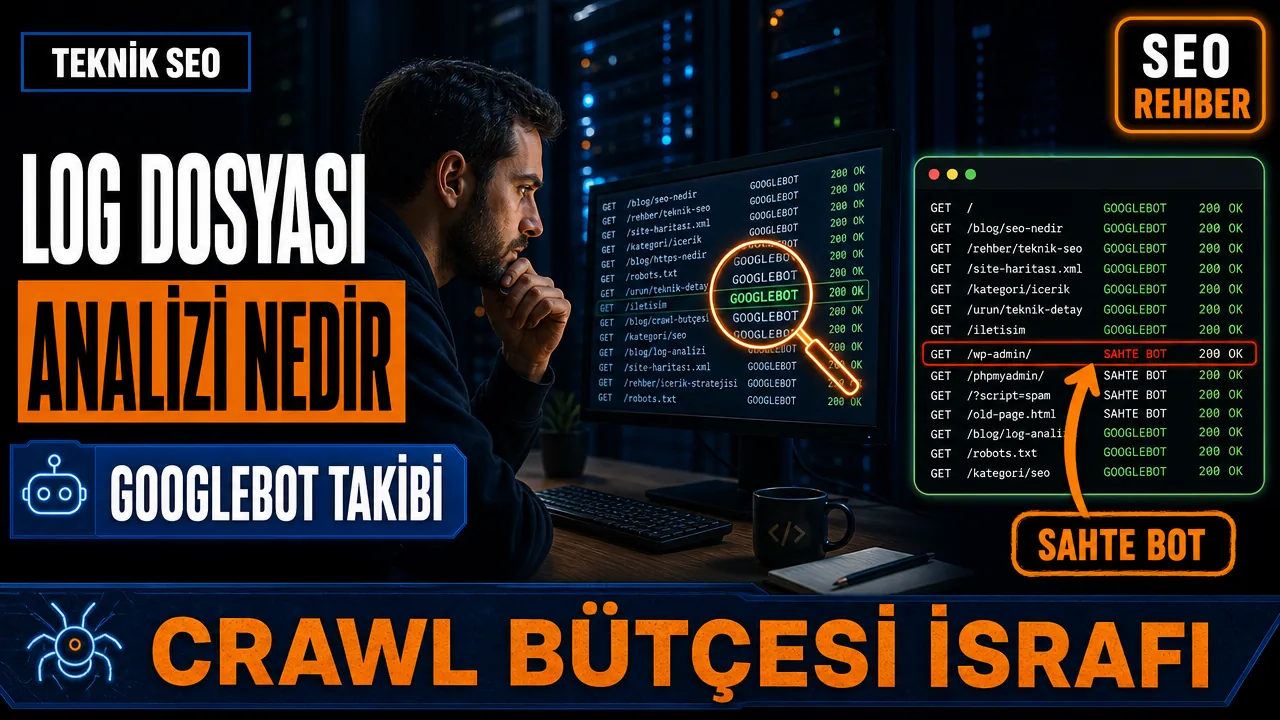
Log dosyası analizi nedir? Log dosyası analizi, web sunucunuzun tuttuğu ham erişim kayıtlarını inceleyerek Googlebot ve diğer arama motoru botlarının sitenizde gerçekte ne yaptığını ortaya çıkarma işlemidir. Google Search Console size indeksleme sonuçlarını gösterirken, log dosyaları “simülasyon değil, botların fiilen yaptığı işlemleri” kayıt altına alır. Bu da onu, crawl bütçesi israfını, unutulmuş (orphan) sayfaları ve yalnızca botların karşılaştığı hataları tespit etmek için yararlı veri kaynaklarından biri haline getiriyor.
Log Dosyası Analizi Nedir, Neden Search Console Yetmez?
Loglar yalnızca kaydedilen istekleri gösterir. CDN veya proxy’de karşılanan istek origin sunucusuna ulaşmayabilir; kapalı, örneklenmiş veya silinmiş loglar da eksiktir. Sunucu, CDN ve Search Console verilerini birlikte okuyun. Bir URL’ye istek gelmesi dizine eklendiği, hiç istek görünmemesi ise sitede iç bağlantısı bulunmadığı anlamına gelmez.
Log Satırında Hangi Veriler Bulunur?
Apache ve Nginx’in standart “combined” log formatı, analiz için yeterli olan yedi temel alanı içerir:
| Alan | Ne İşe Yarar |
|---|---|
| İstemci IP | Ters DNS ile bot doğrulaması yapmayı sağlar |
| Zaman Damgası | Crawl sıklığını ve içerik güncellemesine tepki hızını gösterir |
| İstek URL’si | Crawl payının hangi sayfa şablonlarına gittiğini gösterir |
| HTTP Durum Kodu | Hataları, yönlendirmeleri ve bütçe koruyan 304 yanıtlarını işaretler |
| Yanıt Boyutu | Crawl hızını etkileyen büyük sayfa ağırlığını tespit eder |
| Referrer | İstemci gönderirse önceki sayfayı gösterebilir; bot keşfinin kaynağını kanıtlamaz |
| User-Agent | İlk bot sınıflandırması yapar (tek başına güvenilir değildir) |
66.249.66.1 - - [10/Sep/2026:03:14:22 +0300] "GET /urun/ornek-sayfa HTTP/1.1" 200 15234 "-" "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"User-Agent Sahtekarlığına Karşı Doğrulama
User-Agent bilgisi, isteği yapan tarafından kendi kendine beyan edilir ve kolayca taklit edilebilir. Bu nedenle “sadece User-Agent eşleşmesine bakarak sitenizde gerçekte kimin olduğunu anlayamazsınız.” Gerçek Googlebot trafiğini doğrulamak için Google’ın kendisinin önerdiği iki adımlı ters DNS yöntemi kullanılır:
- İlgili IP adresi üzerinde ters arama yapın (
host [IP]); gerçek Googlebot, googlebot.com, google.com veya googleusercontent.com alan adlarından birine çözümlenmelidir. - Bulunan alan adı üzerinde ileri arama yaparak aynı IP adresine geri döndüğünü doğrulayın.
- Her iki adım da başarılı olmalı; tek yönlü eşleşme yeterli sayılmaz.
Büyük ölçekli doğrulama gerektiğinde Google, OpenAI ve Anthropic gibi şirketler, bot IP aralıklarını makine tarafından okunabilir JSON dosyaları olarak yayınlıyor; bu dosyalar programatik doğrulama için kullanılabiliyor.
Hangi Araçlarla Log Dosyası Analizi Yapılır?
Site büyüklüğüne göre farklı araçlar tercih edilebilir:
- Tablo/betik tabanlı analiz: Küçük ölçekli ve tek seferlik denetimler için uygun, ancak binlerce satırdan sonra pratikliğini kaybediyor.
- Screaming Frog Log File Analyser: Orta ölçekli siteler için pratik standart; Apache, IIS ve Nginx formatlarını destekliyor ve bot doğrulamasını otomatik yapıyor.
- Kurumsal platformlar (Botify, Lumar gibi): Milyonlarca isteği sürekli izlemesi gereken büyük siteler için tasarlanmış.
Crawl Bütçesini Geri Kazanma Adımları
Log dosyası analizinin pratik çıktısı, crawl bütçesinin nereye harcandığını görüp gereksiz alanları temizlemektir. İzlenecek tipik iş akışı şöyle:
- Belirli bir dönem için log örneği toplayın.
- Bot IP’lerini ters DNS ile doğrulayın.
- İstekleri crawler sınıfına göre filtreleyin (Googlebot, Bingbot, AI botları vb.).
- İstekleri sayfa şablonuna göre gruplandırın (ürün sayfası, filtre sayfası, arama sonucu vb.).
- Bu dağılımı, sizin gerçekten sıralanmasını istediğiniz sayfalarla karşılaştırın.
Gereksiz URL oranını sitenizin doğrulanmış bot logundan ölçün; kaynağı ve örneklemi belirtilmeyen yüzde 30–50 aralığını genel gerçek olarak kullanmayın. robots.txt taramayı sınırlayabilir ama dizinden çıkarma aracı değildir. CDN hız yararı sağlayabilir; gereksiz URL keşfini tek başına durdurmaz.
Yayın Sonrası Kontrol Listesi
- robots.txt kısıtlaması, canonical etiketi veya iç link değişikliği gibi düzeltmeleri uyguladınız mı?
- Düzeltmelerden birkaç hafta sonra logları tekrar inceleyip Googlebot’un çabasını istediğiniz sayfalara yönlendirip yönlendirmediğini kontrol ettiniz mi?
- 404 ve 5xx durum kodu döndüren URL’lerin sayısını zamana göre takip ediyor musunuz?
- Yüksek trafik alan ama düşük değerli sayfa şablonlarını tespit edip önceliklendirdiniz mi?
Log Dosyası Analizi ile Crawl Budget Arasındaki İlişki
Log dosyası analizi, aslında crawl budget optimizasyonunun kanıta dayalı temelini oluşturur. Crawl budget teorik bir hedef belirlerken, log analizi bu hedefe ne kadar yaklaşıldığını somut sayılarla gösterir. Büyük e-ticaret siteleri veya çok sayıda kategori/etiket sayfası olan içerik siteleri için bu iki uygulamanın birlikte yürütülmesi, arama motorlarının sınırlı crawl kapasitesinin doğru sayfalara yönlendirilmesini sağlıyor.
Paylaşımlı Hostingde Log Dosyasına Nasıl Erişilir?
Paylaşımlı hosting ortamında çalışan bir WordPress sitesinde ham erişim loglarına genellikle cPanel üzerinden “Raw Access Logs” bölümünden ulaşılabiliyor; bazı sağlayıcılar logları belirli bir süre sonra otomatik olarak siliyor, bu yüzden düzenli analiz yapılacaksa logların haftalık veya aylık olarak indirilip arşivlenmesi gerekiyor. Yönetilen (managed) WordPress hostinglerinde ise ham log erişimi kısıtlı olabilir; bu durumda sağlayıcının sunduğu analitik panelini veya Cloudflare gibi bir CDN/WAF katmanının kendi log dışa aktarma özelliğini kullanmak alternatif bir yol sunuyor.
Pratikte bu kısıtlama, küçük ve orta ölçekli WordPress siteleri için log analizinin neden genellikle aylık bir rutin haline getirildiğini açıklıyor: sağlayıcı log saklama süresine bağlı olarak, belirli bir pencerede indirilen veriler üzerinden dönemsel bir değerlendirme yapılıyor. Kurumsal düzeydeki sitelerde ise sunucu tarafında log toplama ve saklama süresi genellikle özel olarak yapılandırılıyor.
Sonuç
Log dosyası analizi, teknik SEO çalışmalarının en somut ve veriye dayalı parçalarından biri. Search Console’un veremeyeceği ayrıntı düzeyinde, botların sitenizde gerçekte ne yaptığını gösteriyor ve crawl bütçesi israfını ortadan kaldırmak için net bir yol haritası sunuyor. Küçük bir site işletiyorsanız basit bir tablo analizi yeterli olabilir; büyük ve karmaşık bir site söz konusuysa Screaming Frog Log File Analyser gibi araçlarla düzenli analiz yapmak, uzun vadede indeksleme kalitenizi doğrudan etkileyecektir.
Sık Sorulan Sorular
Log dosyası analizi nedir ve neden önemlidir?
Log dosyası analizi, sunucu erişim kayıtlarını inceleyerek arama motoru botlarının sitede gerçekte ne yaptığını ortaya koyan bir tekniktir; crawl bütçesi israfını ve bot-özel hataları tespit etmenin en güvenilir yoludur.
Log dosyası analizi için hangi araçları kullanabilirim?
Küçük siteler için basit tablo/betik analizleri yeterli olabilir; orta ölçekli siteler için Screaming Frog Log File Analyser yaygın olarak tercih edilirken, çok büyük siteler Botify veya Lumar gibi kurumsal platformlara yöneliyor.
Bir isteğin gerçekten Googlebot’tan geldiğini nasıl anlarım?
User-Agent bilgisi tek başına güvenilir değildir; IP adresi üzerinde ters DNS araması yapıp sonucun googlebot.com, google.com veya googleusercontent.com alan adlarından birine çözümlendiğini, ardından bu alan adının aynı IP’ye geri döndüğünü doğrulamanız gerekir.
Crawl bütçesi israfına en çok hangi sayfa türleri neden olur?
Faceted navigation kombinasyonları, site içi arama sonuç sayfaları, derin sayfalama ve oturum kimlikli URL’ler, crawl bütçesinin gereksiz yere tüketildiği başlıca alanlar arasında yer alıyor.
Log dosyası analizini ne sıklıkla yapmalıyım?
Sabit bir kural olmasa da, büyük veya sık güncellenen sitelerde aylık ya da önemli bir teknik değişiklikten birkaç hafta sonra tekrar log analizi yapmak, düzeltmelerin gerçekten etkili olup olmadığını görmek için makul bir yaklaşımdır.
Ters DNS sonucunu alan adı sınırıyla doğrulayın; googlebot.com.evil.example güvenilir değildir. İleri DNS’de aynı IP’ye dönüşü ve Google’ın ilgili crawler/fetcher IP listesini birlikte kontrol edin. Google’a ait her fetcher Googlebot değildir. Küçük sitelerde crawl bütçesi genellikle ana sorun değildir; içerik, iç bağlantı ve sunucu hatalarını önce inceleyin.