Makine öğrenmesi, yazılımın örnek verilerdeki ilişkilerden bir model öğrenerek yeni veriler için tahmin, sınıflandırma veya başka bir çıktı üretmesidir. Örneğin bir spam filtresi, geçmişte etiketlenmiş iletilerden yararlanıp yeni e-postanın istenmeyen ileti olma olasılığını hesaplayabilir. Geliştirici her sözcük için ayrı kural yazmak yerine, veriden öğrenen bir yöntem kurar. Bu sistem yine de hedef, veri ve denetim kararları bakımından insan tasarımına bağlıdır.
Bu rehber, makine öğrenmesinin yapay zekâ içindeki yerini, denetimli ve denetimsiz öğrenmeyi, model geliştirme adımlarını ve sonuçları değerlendirirken yapılan yaygın hataları sade örneklerle açıklar. Amaç, yalnızca terimleri ezberletmek değil; bir “%99 doğru” iddiasının ne zaman anlamlı olduğunu da göstermek.
Makine öğrenmesi nedir?
Bir makine öğrenmesi modeli, eğitim örneklerinden sayısal ilişkiler öğrenir ve daha önce görmediği bir girdide bu ilişkileri kullanır. Girdi bir ürünün fiyat ve boyut bilgisi, bir fotoğrafın pikselleri, e-postanın metni veya sensör kaydı olabilir. Çıktı “spam/normal” sınıfı, tahmini ev fiyatı, benzer ürün grubu ya da yeni bir metin olabilir. Google’ın makine öğrenmesi açıklaması, modellerin veriyi kullanarak tahmin veya içerik üretebildiğini belirtir.
“Öğrenme” sözcüğü, insanın konuyu anladığı gibi bir anlayışla karıştırılmamalıdır. Model eğitim sırasında bir amaç fonksiyonunu iyileştiren parametreler bulur. Örneğin konut fiyatı tahmininde geçmiş satışlar ile özellikler arasındaki ilişkiyi öğrenir. Yeni bir evin fiyatını verdiğinde bu bir tahmindir; pazarlık, ani piyasa değişimi ve eksik özellikler sonucu etkileyebilir. Modelin başarısı, onu görmediği örneklerde nasıl sınadığınıza bağlıdır.
Yapay zekâ ile makine öğrenmesi arasındaki fark nedir?
Yapay zekâ daha geniş bir alandır: Bir sistemin algılama, planlama, öneri veya içerik üretme gibi görevleri yerine getirmesi için farklı yaklaşımlar kullanılır. Makine öğrenmesi bu alanın veriden model çıkaran yöntemleridir. Açıkça tanımlanmış kurallarla çalışan bir uzman sistemi de yapay zekâ tarihinde yer alabilir; o sistemin mutlaka örneklerden öğrenmesi gerekmez. Bugün yaygın ürünler birden fazla yöntemi birlikte kullanabildiği için sınırlar ürün etiketinden anlaşılmaz.
Derin öğrenme, çok katmanlı yapay sinir ağları kullanan makine öğrenmesi yöntemlerini anlatır. Genel ilişki şöyle okunabilir: derin öğrenme makine öğrenmesinin içinde, makine öğrenmesi de yapay zekâ alanının içindedir. Fakat her makine öğrenmesi projesi derin sinir ağı gerektirmez. Az sayıda anlamlı değişkenle açıklanabilen bir problemde daha basit bir model daha ucuz, daha kolay denetlenebilir ve yeterince başarılı olabilir. Konunun devamı için derin öğrenme rehberine bakabilirsiniz.
Bir makine öğrenmesi sistemi nasıl çalışır?
Önce çözülecek soru belirlenir: “Bu ileti spam mi?”, “Yarın kaç ürün satılabilir?” veya “Hangi kayıtlar birbirine benziyor?” Sorudan sonra veri toplanır, izin ve kalite kontrolü yapılır. Veri modelin kullanabileceği özelliklere dönüştürülür. Denetimli görevde doğru cevaplar, yani etiketler de hazırlanır. Model örneklerin bir bölümünde eğitilir; ayrı örneklerde sınanır. Uygun bulunursa yeni girdiler üzerinde tahmin yapmak için kullanılır ve gerçek kullanım hataları izlenir.
Spam örneğinde özellikler gönderici alanı, bağlantı sayısı veya metin örüntüleri olabilir. Etiket geçmişteki “spam/normal” kararlarıdır. Model, özelliklerle etiketler arasındaki ilişkiyi öğrenir. Gelen yeni iletide bir olasılık üretir; ürün belirli bir eşik kullanarak iletiyi klasöre taşır. Eşik çok katıysa reklamlar içeri sızar; çok gevşekse önemli mesajlar spam klasörüne gidebilir. Bu yüzden model kalitesi yalnızca algoritmanın seçimi değil, kullanıcıya verilen geri alma ve düzeltme imkânıyla da ilgilidir.
Veri, özellik, etiket ve model ne demek?
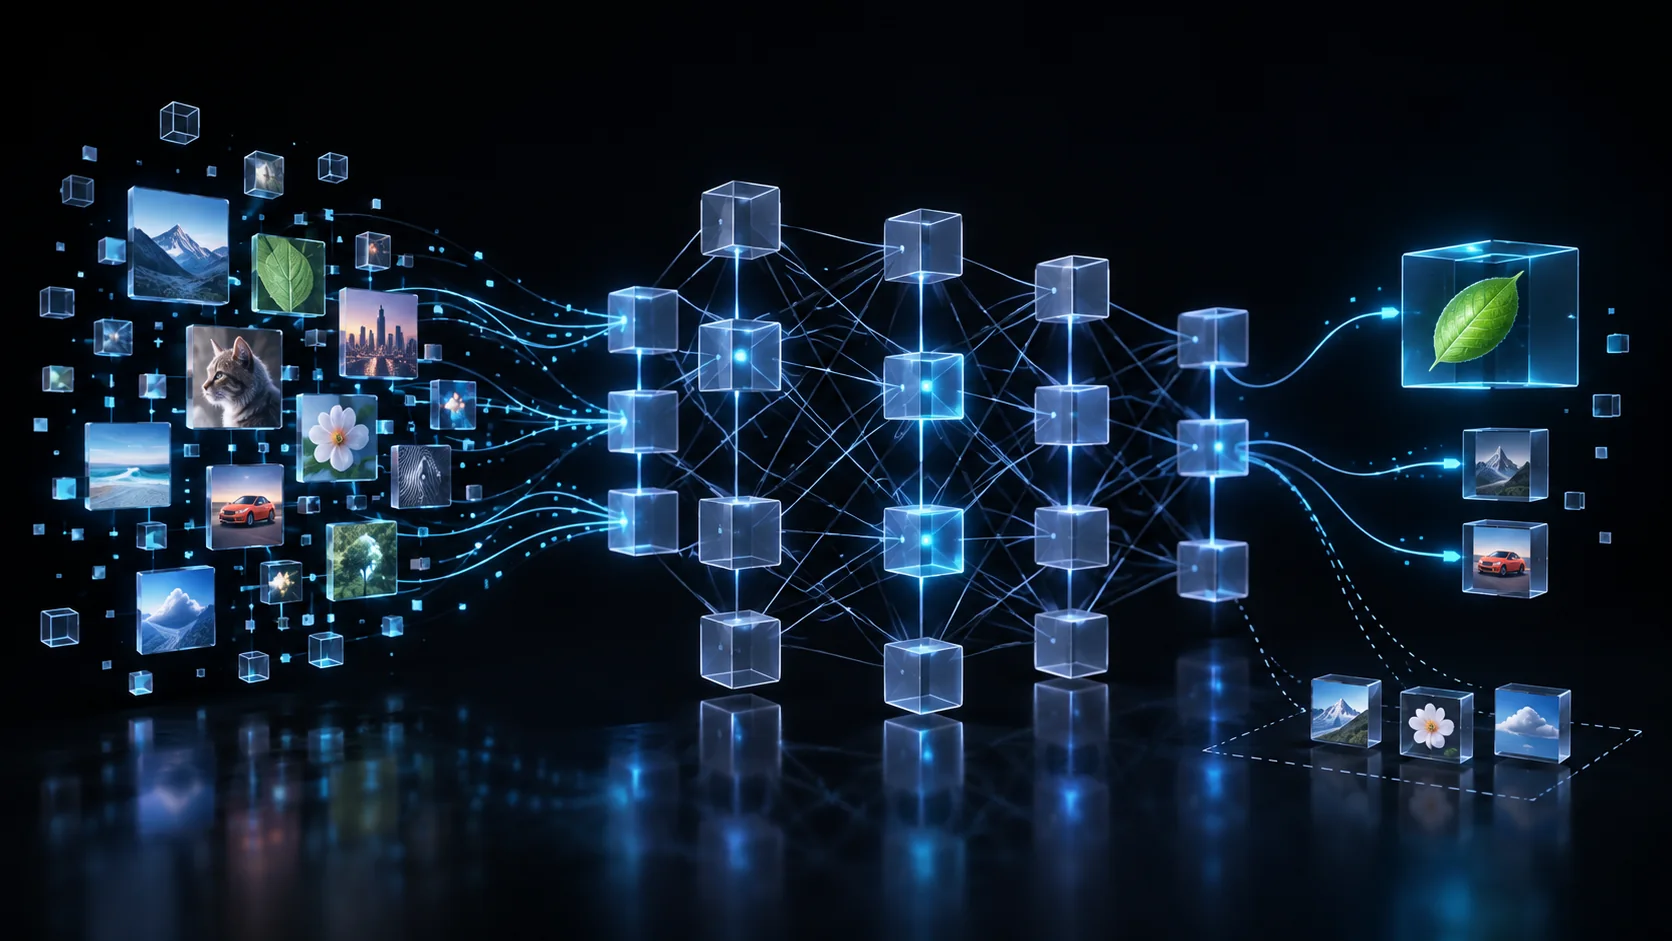
Veri, soruyla ilgili kayıtlardır. Her kayıt bir örnek olabilir. Özellik, modelin girdi olarak kullandığı ölçülebilir bilgidir: evin metrekaresi veya e-postanın bağlantı sayısı gibi. Etiket, denetimli öğrenmede tahmin edilmesi istenen doğru cevaptır; evin satış fiyatı veya iletinin spam olup olmadığı. Model, eğitim sonucu oluşan ve yeni örneğe çıktı verebilen matematiksel ilişkidir. Bunları karıştırmak projeyi yanlış kurmaya yol açar.
Ev fiyatı örneğinde satış sonrası öğrenilen gerçek fiyat etiket olarak kullanılabilir. Ancak satış fiyatını dolaylı biçimde önceden açığa çıkaran bir alanı özelliklere koymak, sahte bir başarı yaratır. Kullanım anında bilinmeyen bilgi eğitimde modele verilirse canlı tahmin başarısız olur. Verinin güncel, temsil edici ve kullanım izni olan bir kaynaktan gelmesi önemlidir. Çok kayıt tek başına iyi model sağlamaz; yanlış etiketler ve tekrar eden örnekler ölçümü çarpıtabilir.
Denetimli öğrenme nedir?
Denetimli öğrenmede eğitim örnekleriyle birlikte beklenen cevaplar verilir. Model yeni bir örnekte bu cevabı tahmin etmeyi öğrenir. İki yaygın görev sınıflandırma ve regresyondur. Sınıflandırma “spam/normal” veya “bitki türü A/B/C” gibi ayrık sınıflar üretir. Regresyon fiyat, sıcaklık veya satış adedi gibi sayısal değer tahmin eder. Google’ın denetimli öğrenme rehberi özellik, etiket, eğitim ve görülmemiş veri üzerindeki değerlendirme ayrımını anlatır.
Denetimli öğrenme, doğru cevapların güvenilir olduğu durumlarda yararlıdır. Fakat etiketleme pahalı veya belirsiz olabilir. Bir fotoğrafa “kedi” etiketi vermek kolay görünür; kısmen görünen hayvan, bulanık görüntü veya birden fazla nesne işleri zorlaştırır. Modelin hangi durumlarda hata yaptığını yalnızca toplam puandan anlayamazsınız. Farklı ışık, cihaz, dil veya kullanıcı gruplarında sonuçları ayrıca ölçmek gerekir.
Denetimsiz öğrenme nedir?
Denetimsiz öğrenmede örneklerde hazır doğru cevap etiketleri bulunmaz. Sistem benzerlikleri, grupları veya verideki yapıyı arar. Kümeleme, benzer kayıtları gruplara ayıran yaygın bir örnektir. Bir mağaza müşterilerinin alışveriş örüntülerini incelerken farklı davranış kümeleri görebilir; bunların “sadık”, “yeni” veya başka bir anlam taşıdığına insan analiziyle karar verilir. Modelin oluşturduğu grup adı kendiliğinden doğruluk kanıtı değildir.
Denetimsiz yöntemler veri keşfinde yararlı olabilir, ancak sonuç kullanılan özellik ve uzaklık ölçüsüne duyarlıdır. Sadece harcama miktarına bakarsanız bir küme, ürün tercihlerinden çok gelir düzeyini yansıtabilir. Bulguyu kullanıcıya uygulanacak bir karara dönüştürmeden önce grupların anlamını, kararlılığını ve ayrımcılık riskini değerlendirin. Etiketsiz veride de veri kalitesi ve gizlilik gereksinimleri ortadan kalkmaz.
Pekiştirmeli ve üretken öğrenme nereye oturur?
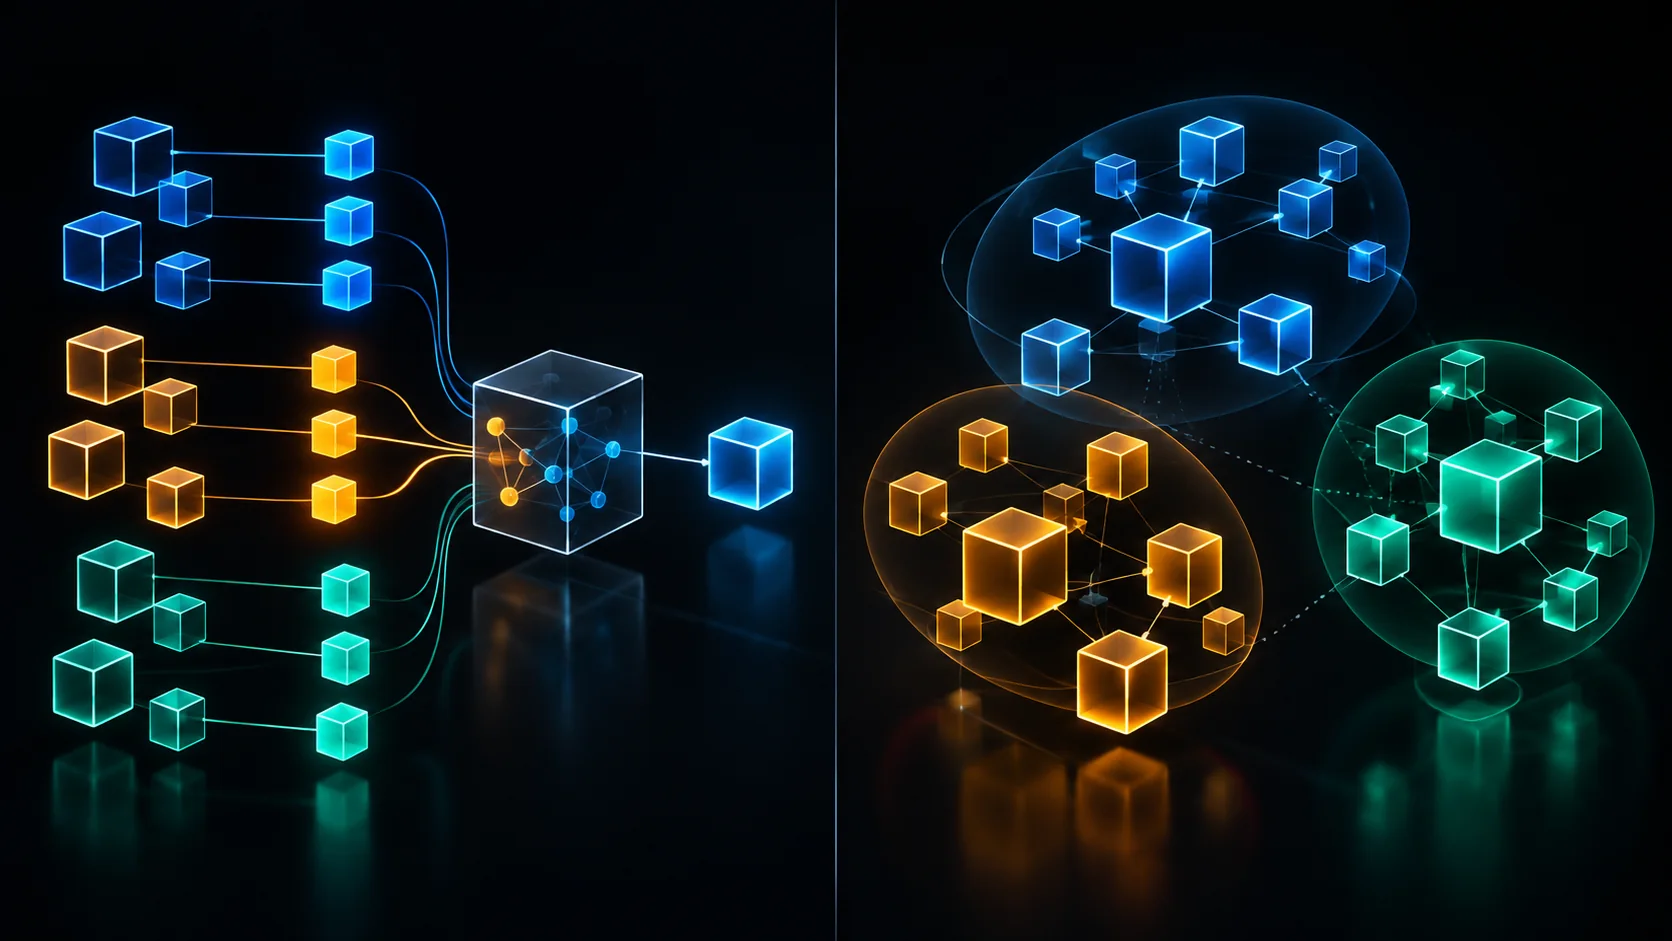
Pekiştirmeli öğrenmede bir sistem, ortamda yaptığı eylemler için ödül veya ceza alarak strateji geliştirir. Bir oyunda hamle seçen ajan buna örnek olabilir. Bu yaklaşım “etiketli tabloyu okuma” görevinden farklıdır; eylemlerin sonraki durumu değiştirmesi önemlidir. Gerçek dünyaya uygulanırken ödülün yanlış tasarlanması istenmeyen davranışa yol açabilir. Google’ın ML giriş rehberi bu yöntemleri farklı öğrenme türleri olarak tanıtır.
Üretken yapay zekâ ise yeni metin, görsel, ses veya video oluşturur. Bazı üretken sistemler önce geniş, etiketsiz veride örüntü öğrenir; ardından belirli görevler için ek eğitim alabilir. Bu nedenle “denetimli mi, üretken mi?” sorusu her zaman tek seçenekli değildir: Biri eğitim düzenini, diğeri üretilen işlevi anlatabilir. Ayrıntılı örnekler için üretken yapay zekâ rehberine geçin.
Eğitim, doğrulama ve test verisi neden ayrılır?
Bir modelin eğitim örneklerinde başarılı olması şaşırtıcı değildir; onları zaten görmüştür. Asıl soru yeni veride ne yaptığıdır. Bu yüzden kayıtlar görev için uygun biçimde eğitim, doğrulama ve test kümelerine ayrılır. Eğitim kümesi parametreleri öğrenmek içindir. Doğrulama kümesi model ve ayar seçimine yardım eder. Test kümesi son seçimi daha önce görülmemiş örneklerde değerlendirmek için saklanır. Google’ın veri bölme rehberi aynı test kümesini sürekli ayar yapmak için kullanmanın ölçümü yanıltabileceğini açıklar.
Bölme yöntemi veriye bağlıdır. Zaman serisinde gelecekteki verileri geçmişi tahmin etmek için eğitimde kullanamazsınız; kronolojik ayrım gerekebilir. Aynı kişinin çok benzer kayıtları hem eğitimde hem testteyse model kişiyi tanıyıp gerçek genelleme gücünden yüksek puan alabilir. Aynı ürün fotoğrafının kopyaları da benzer sorun yaratır. Verinin eğitim ve testte rastgele ayrılması tek başına bu sızıntıları çözmez. Son testin, sistemin gerçek kullanım koşullarına benzeyen örnekleri içermesi gerekir.
Veri sızıntısı nedir ve nasıl önlenir?
Veri sızıntısı, tahmin anında bilinmeyecek bir bilginin eğitim veya değerlendirme sırasında modele ulaşmasıdır. Örneğin hastane randevusuna gelmeme olasılığı tahmin edilecekse randevudan sonra girilen “gelmedi” kodu özellik olarak kullanılamaz. Böyle bir model testte kusursuz görünebilir ama randevudan önce işe yaramaz. Sızıntı yalnızca açık etiketin yanlışlıkla özelliklere girmesi değildir; tüm veri üzerinde hesaplanmış ortalama ile normalizasyon yapmak da test kümesinden bilgi taşıyabilir.
scikit-learn’in yaygın hatalar rehberi, veri hazırlama işlemlerinin yalnızca eğitim verisinden öğrenilip diğer kümelere aynı biçimde uygulanmasını önerir. Pratik kontrol sorusu şudur: “Bu alanı ve bu dönüşümün parametresini gerçek tahmin anında biliyor olacak mıyım?” Yanıt hayırsa modeli yeniden kurun. Veri sızıntısı, yüksek puanlı ama işe yaramayan ürünlerin önemli nedenlerinden biridir.
Aşırı uyum ve yetersiz uyum ne demek?
Aşırı uyumda model eğitim örneklerindeki rastlantısal ayrıntılara gereğinden fazla bağlanır; eğitimde iyi, yeni veride kötü sonuç verir. Bir öğrenci soruların cevaplarını ezberleyip farklı soru geldiğinde zorlanıyorsa benzer bir durum düşünün. Yetersiz uyumda ise model veri içindeki önemli ilişkiyi öğrenemeyecek kadar basit veya eksik eğitilmiştir. Her ikisinde de yeni örnek başarısı düşer. Google’ın aşırı uyum açıklaması veri temsilinin ve model karmaşıklığının etkisini vurgular.
Çözüm otomatik olarak daha fazla veri veya daha büyük model değildir. Önce etiketleri ve bölmeleri kontrol edin. Gereksiz özellikleri çıkarın, daha basit bir temel modelle karşılaştırın, uygun düzenlileştirme ve doğrulama yöntemleri kullanın. Eğitim ve doğrulama sonuçlarını birlikte inceleyin: İki sonuç da kötü ise problem tanımı ya da özellikler yetersiz olabilir. Aralarında büyük fark varsa aşırı uyum veya dağılım farkı araştırılmalıdır. Gerçek kullanım verisi zamanla değişebileceğinden başarıyı yayımdan sonra da izleyin.
Model başarısı hangi ölçülerle değerlendirilir?
Sınıflandırmada doğruluk oranı, doğru kararların tüm kararlar içindeki payıdır. Fakat dengesiz veri için tek başına yetersizdir. Bin e-postanın 990’ı normal, 10’u spam ise her şeye “normal” diyen sistem %99 doğruluk elde eder ama hiçbir spam iletisini bulamaz. Kesinlik, spam diye işaretlenenlerin ne kadarının gerçekten spam olduğunu; duyarlılık ise gerçek spam iletilerinin ne kadarının yakalandığını gösterir. Google’ın sınıflandırma ölçüleri rehberi bu ölçülerin görev ve hata maliyetine göre seçilmesi gerektiğini açıklar.
Yanlış pozitif ve yanlış negatifin maliyetini düşünün. Spam filtresinde yanlışlıkla önemli bir e-postayı gizlemek ciddi olabilir; tehlikeli bir durumu tarayan sistemde tehlikeyi kaçırmak daha ağır olabilir. Eşik değiştirilince kesinlik ve duyarlılık da değişebilir. Tek bir “en iyi” değer yoktur. Farklı kullanıcı gruplarında hata oranlarını ayrıca inceleyin. Regresyonda ise tahmin ile gerçek değer arasındaki ortalama mutlak hata gibi ölçüler kullanılabilir; yüksek ve düşük fiyatlı örneklerde hatayı ayrı görmek yararlıdır.
Somut örnek: E-posta spam filtresi nasıl geliştirilir?
Önce görev açık yazılır: Gelen iletileri otomatik ayırırken önemli mesajları kaybetmemek. Ardından izinli ve farklı dönemlerden örnekler toplanır. Etiketler kontrol edilir; yanlış işaretlenmiş iletiler düzeltilir. Eğitim ve test ayrımı yapılırken aynı kampanyanın neredeyse kopya e-postalarının iki kümeye dağılması önlenir. Basit bir temel model kurulur: Örneğin belirli yaygın işaretlere bakarak karar veren bir kural sistemi. Daha sonra öğrenen model bu temel ile karşılaştırılır.
Model doğrulama verisinde denendikten sonra eşik seçilir. Testte yalnızca toplam doğruluğa bakılmaz; spam yakalama oranı ve yanlışlıkla gizlenen normal iletiler sayılır. İlk canlı kullanımda kullanıcıya “spam değil” geri bildirimi ve klasör kontrolü sunulur. Yeni dolandırıcılık kalıpları ortaya çıktığında performans yeniden ölçülür. Bu örneğin dersi şudur: Model bir defa eğitilip unutulan bir dosya değildir; veri, karar eşiği, kullanıcı arayüzü ve geri bildirim birlikte çalışır.
Makine öğrenmesi nerelerde kullanılır?
Günlük yaşamda istenmeyen ileti ayırma, arama sonuçlarını sıralama, konuşmayı yazıya dönüştürme, görselde nesne tanıma, rota ve varış süresi tahmini gibi görevlerde makine öğrenmesi kullanılabilir. Ancak bir ürünün belirli sürümünün gerçekten hangi yöntemi kullandığı üreticisine göre değişir. “Akıllı” sözcüğü teknik kanıt değildir. İş süreçlerinde talep tahmini, arıza sinyali analizi veya belge sınıflandırma gibi işler de uygundur; sonuçların kalitesi toplanan verinin temsil gücüne bağlıdır.
Makine öğrenmesi özellikle çok sayıda örnek ve değişken arasında açıkça yazılması zor ilişkiler bulunduğunda yararlı olabilir. Yine de kullanıcı sorusunu çözmüyorsa gereksiz karmaşıklık ekler. Bir küçük mağazada beş ürünün stok sınırını sabit kuralla yönetmek yeterli olabilir; büyük ve mevsimsel bir katalogda tahmin modeli değer sağlayabilir. Teknik yöntem seçimi, pazarlama etiketinden önce iş sorusuna ve hata maliyetine dayanmalıdır.
Ne zaman makine öğrenmesine gerek yok?
Bir görev açık, güvenilir ve az sayıda kuralla çözülebiliyorsa basit yazılım çoğu zaman daha anlaşılırdır. “Sipariş tutarı belirli eşiği geçerse ücretsiz kargo göster” kuralı için model eğitmek gerekmez. Yeterli ve izinli veri yoksa, doğru etiketler üretilemiyorsa veya kararın nedenini açıklamak zorunluysa, ML projesi beklenen faydayı vermeyebilir. Ayrıca modelin yanlış kararı ciddi zarara neden oluyorsa insan onayı ve sıkı sınırlar gerekir.
Başlamadan önce bir temel yöntem belirleyin: Sabit kural, ortalama tahmin veya elle inceleme. Yeni model bu yöntemi anlamlı ölçüde geçmiyorsa bakım ve veri toplama maliyeti haklı olmayabilir. “Öğreniyor” olması tek başına üstünlük sağlamaz. Kullanıcının gerçekten ihtiyacı olan sonuç; daha az hata, daha hızlı işlem veya daha iyi erişilebilirlik olabilir.
Veri kalitesi, gizlilik ve adalet neden önemlidir?
Veri belirli insanları, cihazları veya dönemleri eksik temsil ederse model bazı durumlarda sistematik hata yapabilir. Örneğin yalnızca iyi ışıkta çekilmiş fotoğraflarla eğitilen bir tanıma sistemi düşük ışıkta zorlanabilir. Hatanın kimleri etkilediğine bakmadan tek genel puan vermek yanıltıcıdır. Veri toplama ve etiketleme sürecinde izin, amaç sınırlaması ve güvenli saklama da düşünülmelidir. Gereksiz kişisel bilgiyi modele vermek hem risk hem de yanlış ilişki kaynağı olabilir.
Bir modelin kararını insanın düzeltebilmesi önemlidir. Özellikle işe alım, sağlık, kredi veya eğitim gibi yüksek etkili alanlarda sonuçları otomatik hükme dönüştürmeden önce uzman değerlendirmesi ve ilgili kurallara uyum gerekir. Gizlilik ve adalet kontrolü yalnızca ilk veri setinde bitmez; kullanım sırasında dağılım değişebilir. Geri bildirim, itiraz yolu ve performans izleme bu nedenle ürün tasarımının parçasıdır.
Yeni başlayan biri nasıl öğrenebilir?
- Görevi seçin: Spam sınıflandırma veya basit sayısal tahmin gibi sonucu ölçülebilen küçük bir soru belirleyin.
- Örnekleri inceleyin: Hangi sütunlar özellik, hangisi etiket? Eksik ve yanlış kayıtları bulun.
- Temel sonuç alın: Basit kural ya da çoğunluk sınıfı gibi referans oluşturun.
- Veriyi ayırın: Eğitim, doğrulama ve test kümelerini kurarken kişi, zaman ve kopya ilişkilerini düşünün.
- Modeli karşılaştırın: Tek bir puana değil, hata türlerine ve gerçek kullanım koşullarına bakın.
- Sonucu anlatın: Modelin neyi tahmin ettiğini, nerede zorlandığını ve ne zaman kullanılmaması gerektiğini yazın.
Başlangıç için Google Machine Learning Crash Course kavramları alıştırmalarla sunar. Kod uygulaması için scikit-learn belgeleri yararlıdır; fakat önce veri sızıntısı ve değerlendirme mantığını anlamak, yalnızca örnek kodu çalıştırmaktan daha değerlidir. Gerçek kişi verisiyle başlamayın; izinli eğitim verisi kullanın. Küçük bir modelin hatalarını tek tek okumak, büyük bir modelin tek puanına bakmaktan daha öğreticidir.
Sık sorulan sorular
Makine öğrenmesi her zaman sinir ağı mıdır?
Hayır. Karar ağaçları, doğrusal modeller ve başka yöntemler de makine öğrenmesi içinde yer alır. Sinir ağı kullanmak problemin türüne, veri miktarına, maliyete ve açıklama gereksinimine göre seçilir. Basit bir temel modelle karşılaştırma yapmadan daha karmaşık yöntemin üstün olduğunu varsaymayın.
Model daha çok veri görünce mutlaka iyileşir mi?
Hayır. Yeni verinin kalitesi, etiketlerin doğruluğu ve gerçek kullanım koşullarını temsil etmesi önemlidir. Kopya veya hatalı örnekler puanı yapay biçimde yükseltebilir ya da modeli bozabilir. Daha çok veri toplarken mahremiyet ve kullanım izni sınırlarını da gözetin.
Yapay zekâ ile makine öğrenmesi aynı şey mi?
Değil. Yapay zekâ geniş alan, makine öğrenmesi veriden model öğrenen yöntemlerdir. Bir ürün her ikisiyle de tanımlanabilir. Derin öğrenme ise makine öğrenmesinin bir alt grubudur. Bu ilişkiyi yöntemin adı ile uygulamanın yaptığı işi karıştırmadan okumak gerekir.
“%99 doğruluk” iyi bir sonuç mu?
Göreve ve verinin dağılımına bağlıdır. Bin örneğin yalnızca 10’u önemli sınıftaysa hepsini kaçıran model yine %99 doğruluk gösterebilir. Kesinlik, duyarlılık, yanlış pozitif ve yanlış negatif sayıları ile gerçek kullanım verisine bakın.
Sonuç
Makine öğrenmesi, veriden öğrendiği ilişkileri yeni örneklere uygulayan güçlü bir araçtır. Değerini algoritma adı değil, doğru tanımlanmış görev, güvenilir veri, dürüst test ve yönetilebilir hata belirler. Yapay zekâdan farkı kapsam; denetimli ve denetimsiz öğrenmeden farkı ise kullandıkları bilgi türüdür. Öğrenmeye küçük ve ölçülebilir bir problemle başlayın, basit çözümle karşılaştırın ve modelin sınırlarını görünür tutun.
Kaynaklar ve ileri okuma
- Google for Developers: What is Machine Learning? — temel tanım ve öğrenme türleri.
- Google for Developers: Supervised Learning — özellik, etiket ve tahmin.
- Google ML Crash Course: Dividing Datasets — eğitim, doğrulama ve test.
- Google ML Crash Course: Classification Metrics — doğruluk, kesinlik ve duyarlılık.
- scikit-learn: Common Pitfalls — veri sızıntısı ve doğru veri hazırlama.