Derin öğrenme nedir? Kısa yanıt: Çok katmanlı yapay sinir ağlarının verideki örüntüleri öğrenmesini sağlayan makine öğrenmesi yaklaşımıdır. Bir fotoğraftaki nesneyi tanımak, konuşmayı yazıya çevirmek veya metin üretmek için kullanılabilir. “Derin” sözcüğü, modelin insan gibi derin düşündüğü anlamına gelmez; girdinin art arda gelen işlem katmanlarından geçtiğini anlatır.
Bu rehberde bir sinir ağının tahmini nasıl ürettiğini, eğitim sırasında hatalarından nasıl öğrendiğini ve ne zaman gerçekten işe yaradığını somut örneklerle inceleyeceğiz. Genel çerçeve için yapay zekâ rehberine, yöntemlerin karşılaştırması için makine öğrenmesi yazısına da bakabilirsiniz.
Derin öğrenme, yapay zekâ ve makine öğrenmesi arasında nerede durur?
Yapay zekâ, bilgisayarların algılama, tahmin ve karar verme gibi görevleri yerine getirmesini amaçlayan geniş alandır. Makine öğrenmesi, kuralları tek tek yazmak yerine örneklerden bir model çıkarır. Derin öğrenme ise makine öğrenmesi içindeki, özellikle çok katmanlı sinir ağlarına dayanan yöntemler topluluğudur. Her derin öğrenme sistemi bir makine öğrenmesi sistemidir; her makine öğrenmesi sistemi derin öğrenme kullanmaz.
Örneğin bir mağazanın satışlarını birkaç sayısal değişkene göre tahmin etmek için doğrusal regresyon veya ağaç tabanlı bir model yeterli olabilir. Binlerce farklı açıdan çekilmiş ürün fotoğrafında nesneleri ayırmak ise görüntünün karmaşık özelliklerini öğrenen derin ağlardan yararlanabilir. Hangi yöntemin uygun olduğu veri türüne, örnek sayısına, doğruluk ihtiyacına ve çalışma maliyetine bağlıdır.
Yapay sinir ağı hangi parçalardan oluşur?
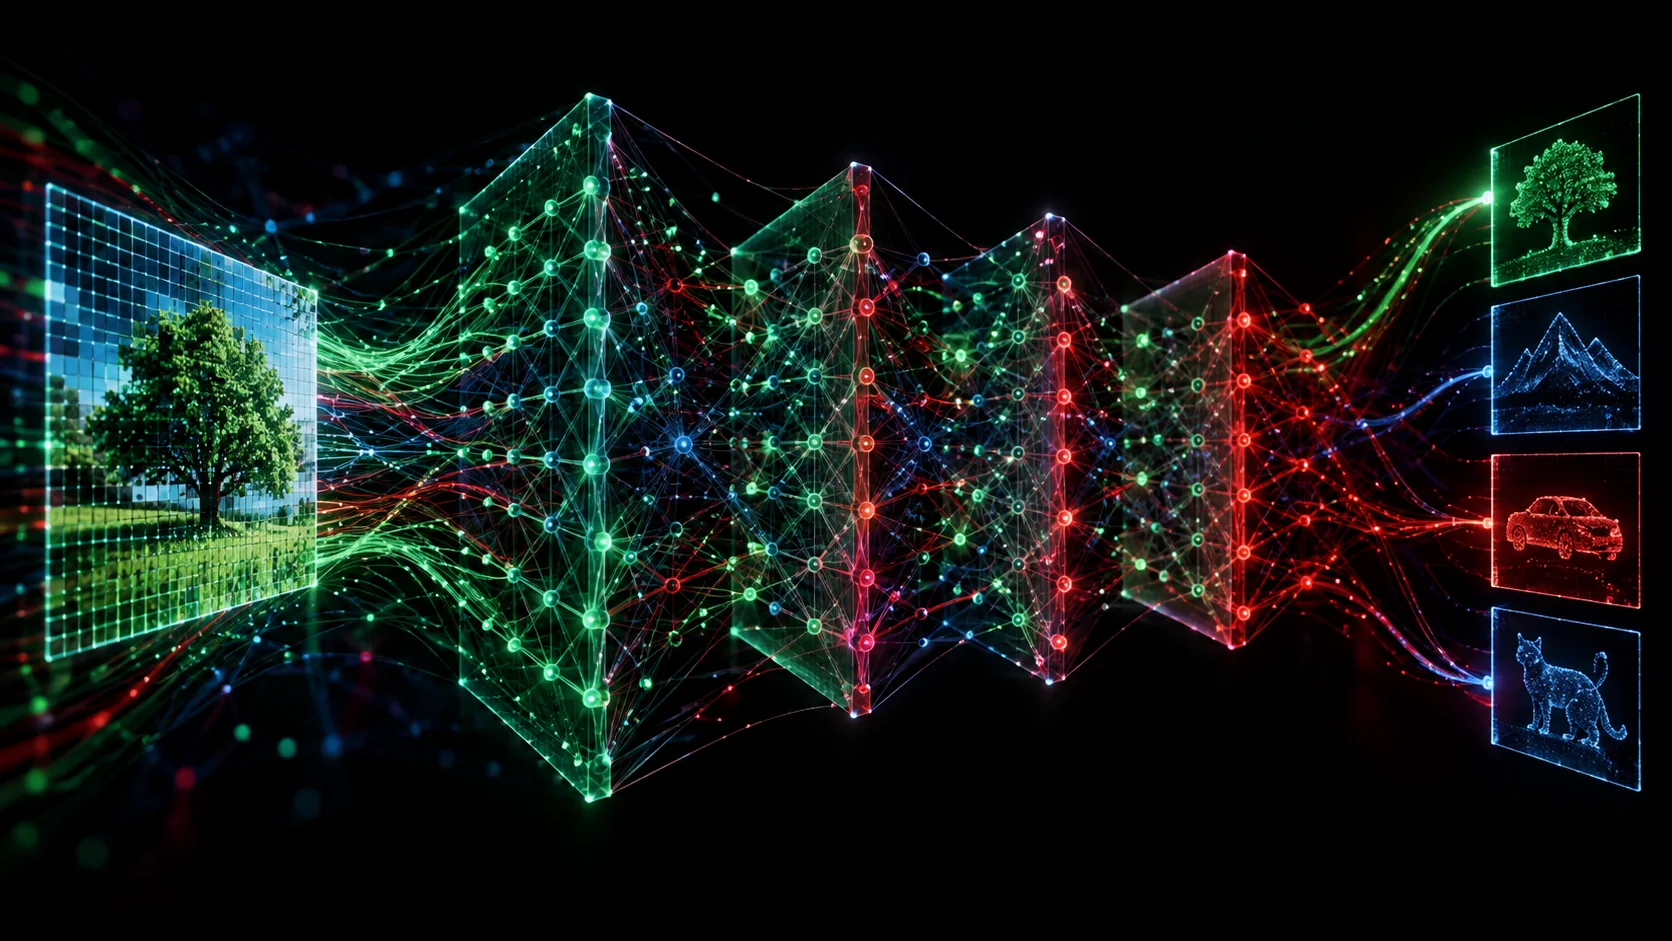
Sinir ağı, veriyi alan bir giriş katmanı, ara temsiller üreten gizli katmanlar ve tahmini veren bir çıkış katmanı içerir. Her katmanda düğüm denen hesaplama birimleri vardır. Bir düğüm önce gelen sayıları ağırlıklarla çarpar, toplar, bir sapma terimi ekler ve sonucu bir aktivasyon işlevinden geçirir. Eğitim, bu ağırlık ve sapma değerlerinin ayarlanmasıdır.
Ağırlık, gelen bilginin o düğüm için ne kadar etkili olduğunu belirler. Sapma, düğümün karar eşiğini kaydırmaya yardım eder. Aktivasyon işlevi ise ağa doğrusal olmayan ilişkileri öğrenme olanağı verir. Yalnızca doğrusal işlemleri üst üste koymak, katman sayısı artsa bile tek bir doğrusal dönüşümle eşdeğer kalır. Google’ın düğüm ve gizli katman ile aktivasyon işlevi açıklamaları bu yapı taşlarını örneklerle gösterir.
Katmanlar neden önemlidir?
Bir görüntü sınıflandırma örneğini düşünün. İlk işlemler kenar, renk ve basit doku değişimlerine duyarlı olabilir. Daha ilerideki temsiller, bu basit ipuçlarının birleşimlerinden nesneyi ayırmaya yarayan özellikler oluşturabilir. Bu anlatım kavramsal bir sadeleştirmedir: Gerçek bir ağın her düğümüne “kulak” veya “göz” gibi açık bir anlam atamak çoğu zaman mümkün değildir. Model, eğitim görevi için yararlı sayısal temsilleri öğrenir.
Bir ağaç fotoğrafı verdiğinizde giriş piksel değerlerinden oluşur. Ara katmanlar görüntüdeki ilişkileri işler. Çıkışta “ağaç”, “bina” ve “hayvan” gibi sınıflara ait skorlar elde edilir. En yüksek skor seçilebilir; fakat yüksek skorun güvenilir bir olasılık olduğu ayrıca sınanmalıdır. Özellikle alışılmadık veya eğitimde görülmemiş görüntülerde model kendinden emin görünen yanlış cevaplar verebilir.
Bir sinir ağı nasıl öğrenir?
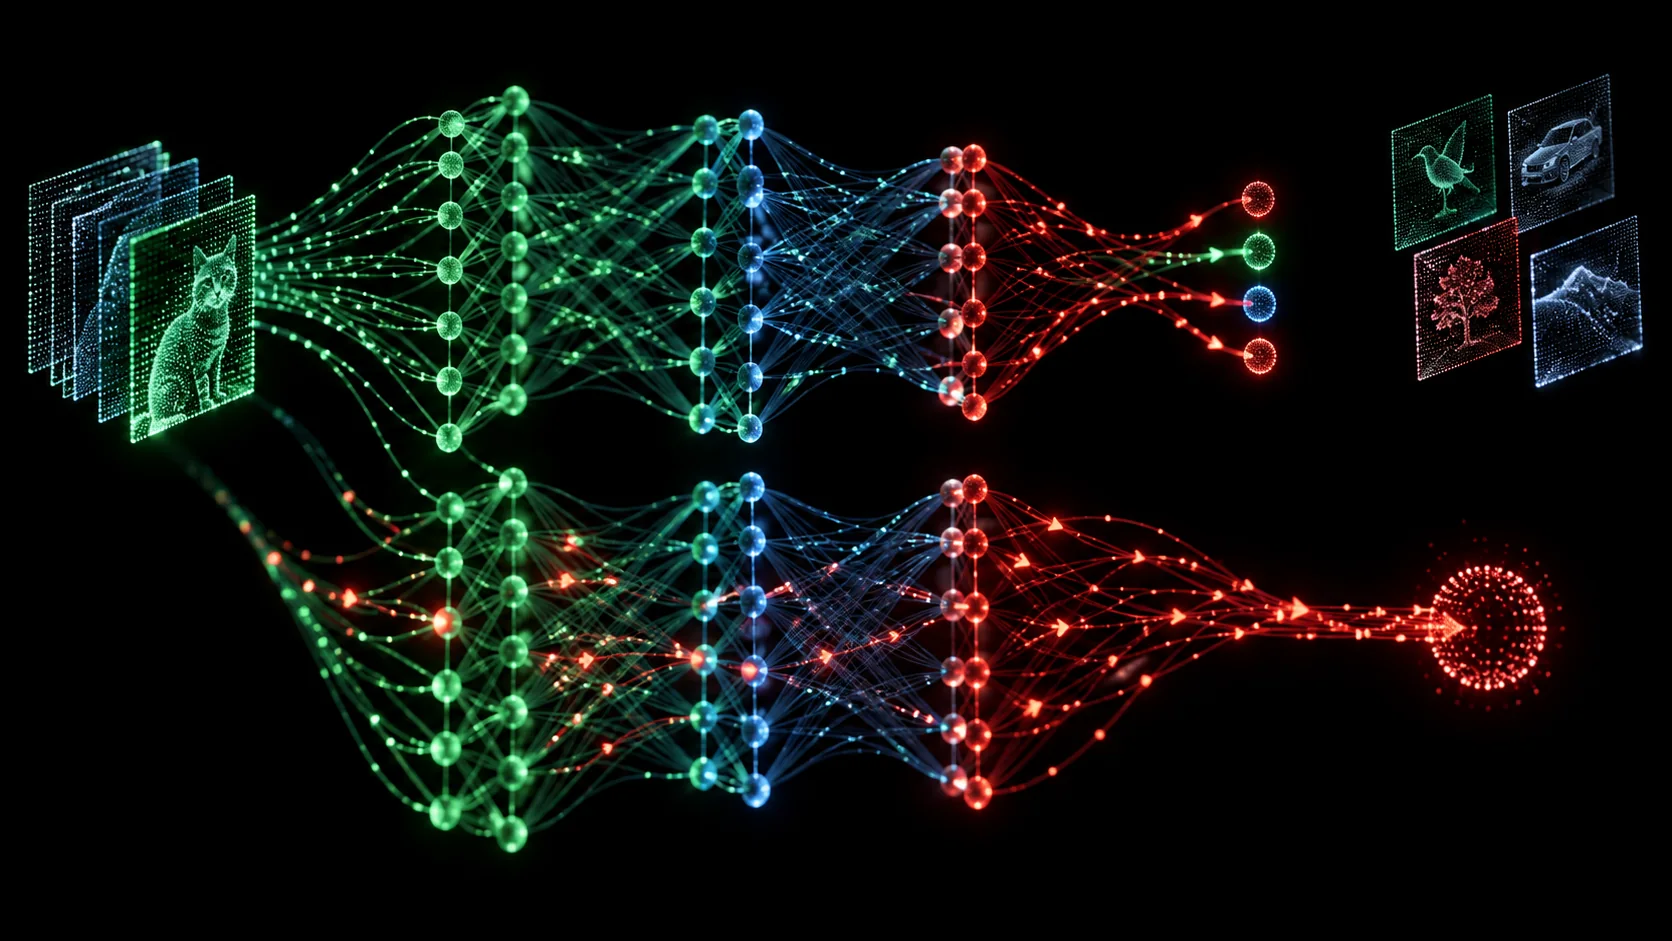
Ağın rastgele başlayan ağırlıklarıyla yaptığı ilk tahminler genellikle kötüdür. Eğitim sırasında etiketli örnekler gösterilir: örneğin “bu görüntü ağaç” bilgisiyle beraber görüntünün kendisi verilir. Model bir tahmin üretir, tahminle doğru etiket arasındaki fark bir kayıp işlevi ile ölçülür, ardından ağırlıklar kaybı azaltacak yönde güncellenir. Bu döngü çok sayıda örnek üzerinde tekrar eder.
Tahminin girişten çıkışa doğru hesaplanmasına ileri geçiş denir. Kayıp hesaplandıktan sonra geri yayılım, her ağırlığın hataya katkısını zincir kuralı yardımıyla bulur. Bu türevler, gradyan inişi veya benzeri bir optimizasyon yöntemiyle parametrelerin nasıl değiştirileceğini belirler. Google’ın geri yayılım açıklaması ve PyTorch otomatik türev rehberi daha teknik ayrıntı sunar.
Öğrenme oranı, her güncellemenin büyüklüğünü etkiler. Çok yüksek bir değer iyi çözümlerin etrafından sıçrayabilir; çok düşük bir değer eğitimi yavaşlatabilir. Tek bir evrensel doğru ayar yoktur. Veri ölçeği, model mimarisi, parti boyutu ve optimizasyon yöntemi birlikte değerlendirilir. Eğitim tamamlandıktan sonra yeni bir örnek için yalnızca ileri geçiş yapıp tahmin üretmek çıkarım olarak adlandırılır.
Eğitim, doğrulama ve test verisi neden ayrılır?
Eğitim kümesi ağırlıkları öğrenmek içindir. Doğrulama kümesi, model seçimi ve ayar denemelerinde yol gösterir. Test kümesi ise süreç sonunda, daha önce kararları etkilememiş örneklerde performansı ölçer. Aynı kişinin, aynı cihazın veya neredeyse aynı fotoğrafın farklı kümelere dağılması sonucu olduğundan iyi gösterebilir. Buna veri sızıntısı denir. Bölmeyi gerçek kullanım koşuluna göre yapmak gerekir; zamanla değişen bir problemde gelecek tarihler ayrı tutulabilir.
Ezberleme ile öğrenme arasındaki fark nedir?
Model eğitim görüntülerini çok iyi tanıyıp yeni görüntülerde zorlanıyorsa aşırı uyum söz konusudur. Örneğin ağ, hastalığı tespit etmek yerine eğitim fotoğraflarının köşesindeki hastane işaretini kullanmış olabilir. Eğitim doğruluğu yüksek görünse de başka hastanede sonuç bozulur. Bu yüzden yalnızca eğitim kaybına bakmak yanıltıcıdır; ayrı veri üzerinde hata, farklı alt gruplarda performans ve gerçek kullanım senaryosu incelenmelidir.
Çözüm tek bir “daha büyük model” düğmesi değildir. Daha temiz ve çeşitli örnek toplamak, veri artırmayı uygun şekilde uygulamak, model karmaşıklığını sınırlamak, düzenlileştirme kullanmak ve eğitim süresini doğrulama sonucuna göre belirlemek yardımcı olabilir. Veri artırma, bozuk etiketleri onarmaz. Google’ın aşırı uyum rehberi eğitim ve genelleme farkını açıklar.
Derin öğrenme hangi veri türlerinde kullanılır?
Derin ağlar tek tip değildir. Görüntü, ses, metin ve zaman dizisi farklı yapılar taşır. Mimari seçimi verinin özelliklerine ve hedef göreve göre yapılır. Bir modelin bir alanda çok başarılı olması, başka alanda otomatik olarak güvenilir olduğu anlamına gelmez.
Görüntüler: Evrişimli ağlar ve görsel modeller
Görüntüde yan yana piksellerin ilişkisi önemlidir. Evrişimli sinir ağları, küçük filtreleri görüntü üzerinde gezdirerek yerel örüntülerden yararlanır. Böylece her pikseli diğer tüm piksellerle ayrı ayrı ilişkilendirmek zorunda kalmadan kenar ve doku gibi ipuçlarını işleyebilir. Bugün görsel görevlerde başka mimariler de kullanılır; “görüntü işleme eşittir yalnızca evrişimli ağ” demek doğru değildir.
Ürün fotoğraflarını sınıflandırmak, uydu görüntüsünde arazi türlerini ayırmak veya üretim hattında kusur adaylarını işaretlemek örneklerdir. Özellikle sağlık görüntülerinde model çıktısı tek başına teşhis yerine geçmez. Veri kalitesi, farklı cihazlarda geçerlilik, uzman değerlendirmesi ve ilgili düzenlemeler ayrı ayrı önem taşır.
Ses: Konuşma ve akustik örüntüler
Konuşmayı yazıya dönüştüren sistemler, ses dalgasındaki zaman içinde değişen örüntülerden yararlanır. Arka plan gürültüsü, aksan, mikrofon kalitesi ve konuşmacılar arasındaki fark başarıyı etkiler. Bir laboratuvar kaydındaki iyi sonuç, kalabalık bir sokaktaki sonuçla aynı olmayabilir. Değerlendirme için hedef kullanıcılara ve ortama benzeyen kayıtlar gerekir.
Metin: Dil modelleri ve transformer mimarisi
Metin üretimi, özetleme ve çeviri gibi görevlerde transformer tabanlı ağlar yaygındır. Bu sistemler, sözcük veya parça dizileri arasındaki bağlamı sayısal temsillerle işler. Ancak akıcı cümle kurmak, her cümlenin doğru veya kaynaklı olduğunu göstermez. Üretken yapay zekâ rehberinde metin ve görsel üretiminin sınırlarını ayrıca anlattık.
Makine öğrenmesi ile derin öğrenme arasındaki farklar
Geleneksel makine öğrenmesinde uzmanlar çoğu zaman girdiden kullanılacak özellikleri tasarlar: bir e-postadaki kelime sayısı veya bir ürünün fiyat değişimi gibi. Derin ağlar, uygun veri ve eğitimle bazı temsilleri kendileri öğrenebilir. Bu, insanın veri temizleme, etiketleme ve değerlendirme sorumluluğunu ortadan kaldırmaz.
| Ölçüt | Daha basit makine öğrenmesi | Derin öğrenme |
|---|---|---|
| Tipik veri | Yapılandırılmış tablolar ve az sayıda değişken | Görüntü, ses, metin ve karmaşık örüntüler |
| Özellik çıkarımı | Çoğu zaman elle tasarlanmış değişkenler | Temsiller eğitim sırasında öğrenilebilir |
| Kaynak ihtiyacı | Çoğu görevde daha düşük olabilir | Büyük modellerde yüksek hesaplama ve bellek |
| Açıklama | Bazı modeller daha kolay yorumlanır | İç kararları anlamak daha güç olabilir |
Tablo bir kural kitabı değildir. Küçük bir derin ağ ucuz çalışabilir; büyük bir ağaç topluluğu da pahalı olabilir. Ayrıca önceden eğitilmiş bir modelin yeniden kullanılması, baştan model eğitmekten çok daha az veri gerektirebilir. İyi seçim, aynı veri bölmesi ve aynı başarı ölçüsüyle karşılaştırılan gerçek denemelerden çıkar.
Derin öğrenmenin güçlü yönleri nelerdir?
Karmaşık girdilerle çalışma: Görüntüdeki biçimleri veya konuşmadaki değişimleri elle tam kurallara dökmek güçtür. Yeterli çeşitlilikte veriyle sinir ağları bu ilişkileri öğrenebilir. Temsil öğrenme: Ara katmanlar ham veriyi görev için yararlı sayısal özelliklere dönüştürür. Aktarım öğrenmesi: Uygun lisans ve koşullarla önceden eğitilmiş bir model yeni bir göreve uyarlanabilir; bu başlangıç maliyetini azaltabilir.
Bu avantajlar her veri kümesinde görülmez. Veri azsa, etiketler tutarsızsa veya problem basit bir kuralla çözülebiliyorsa karmaşıklık fayda getirmeyebilir. Ayrıca güçlü ortalama başarı, nadir ama kritik olaylardaki hataları gizleyebilir. Bu yüzden “hangi koşulda başarılı?” sorusunu “toplam doğruluk kaç?” sorusuyla birlikte sormak gerekir.
Sınırlar, maliyetler ve riskler
Veri bağımlılığı: Model eğitim verisinin kapsamadığı koşullarda zayıflayabilir. Hesaplama maliyeti: Eğitim ve yüksek hacimli çıkarım donanım, enerji, bakım ve gecikme gerektirir. Yorumlama güçlüğü: Hangi görsel ipucunun kararı etkilediğini bulmak bazı ağlarda zordur. Hata riski: Dağılım değişimi, kötü etiket, önyargılı örnekleme veya saldırgan girişler sonucu bozabilir.
Mahremiyet de tasarımın parçasıdır. Kişisel veriyi toplamadan önce gerçekten gerekli olup olmadığına bakılmalı, saklama ve erişim sınırları tanımlanmalıdır. Üçüncü taraf bir modeli kullanırken gönderilen içeriğin nereye gittiği ve nasıl işlendiği anlaşılmalıdır. Kritik bir kararda insan denetimi, itiraz yolu ve hataların izlenmesi ayrıca planlanmalıdır.
Bir derin öğrenme projesi nasıl değerlendirilir?
Önce hedef açık olmalı: “Gelen fotoğrafta ürünü hangi sınıfa koyacağız?” veya “Konuşma kaydını ne kadar doğru yazıya çevireceğiz?” gibi. Ardından basit bir karşılaştırma çizgisi kurulur. Örneğin görüntü görevi için mevcut manuel süreç, hazır bir model veya daha küçük bir yöntem referans olabilir. Derin ağın gerçekten ek değer sağladığı, aynı test koşullarında gösterilmelidir.
- Başarı ölçüsünü seçin: Sınıflandırmada doğruluk tek başına yetmeyebilir; kesinlik, duyarlılık ve sınıf bazında hata da incelenir. Nadir bir hastalık işaretinde yanlış negatif ve yanlış pozitif maliyetleri farklıdır.
- Veriyi temsil edici toplayın: Gerçek kullanıcıları, cihazları, ışık koşullarını ve zor örnekleri kapsayın. Etiketleme yönergesini yazın; uzmanlar arasında anlaşmazlık varsa bunu kaydedin.
- Veriyi doğru bölün: Eğitim, doğrulama ve test ayrımını karar vermeden önce belirleyin. Aynı kaynaktan gelen neredeyse kopya örneklerin kümeler arasında sızmasını önleyin.
- Alt grupları kontrol edin: Ortalama değerin ardında belirli ortam veya kullanıcı gruplarında kötü sonuç gizlenebilir. İlgili alt grupları veri ve etik sınırlar içinde değerlendirin.
- Çalışma koşullarını ölçün: Yanıt süresi, bellek, enerji, hata durumunda geri dönüş ve model güncelleme maliyeti gerçek üründe belirleyicidir.
Yayına alındıktan sonra iş bitmez. Zamanla fotoğraf cihazları, ürünler veya kullanıcı davranışı değişebilir. Modelin gördüğü veri ile eğitim verisi arasındaki fark büyürse performans düşebilir. Örnekleme, kalite izleme, güvenli güncelleme ve gerektiğinde insan incelemesi bu nedenle önemlidir.
Yeni başlayan biri derin öğrenmeyi nasıl öğrenebilir?
İlk adım, bir sinir ağını büyülü bir kara kutu gibi görmek yerine basit bir tahmin makinesi olarak düşünmektir. Sayısal girişler, ağırlıklı toplam, aktivasyon, kayıp ve parametre güncellemesi arasındaki ilişki anlaşılınca daha büyük modellerin mantığı da kolaylaşır. Önce küçük bir veri kümesinde eğitim ve test ayrımını elle uygulamak yararlıdır; hemen dev bir dil modeli eğitmeye çalışmak gereksiz maliyet çıkarır.
İkinci adım, karşılaştırma alışkanlığı edinmektir. Aynı problemde basit bir kural veya klasik model ne kadar başarılı? Derin model nerede iyileşiyor, nerede hata yapıyor? Yanlış sınıflandırılmış örnekleri tek tek görmek, yalnızca tek bir puana bakmaktan daha öğreticidir. Üçüncü adım, küçük değişiklikler yapıp etkisini ölçmektir: veri kalitesini iyileştirmek, öğrenme oranını ayarlamak veya daha küçük bir model denemek gibi.
Kod öğrenmek isteyenler için Python ve bir derin öğrenme kütüphanesi pratik bir başlangıç olabilir. Ancak kütüphane komutlarını ezberlemek, veri sızıntısını veya yanlış başarı ölçüsünü fark etmeyi sağlamaz. Kavramları ve deney tasarımını kodla beraber öğrenmek daha sağlıklı ilerleme sağlar. Google’ın sinir ağları dersi, temel hesaplamaları görselleştirerek açıklayan bir kaynaktır.
Sık sorulan sorular
Derin öğrenme için çok büyük veri şart mı?
Her zaman değil. Görevin güçlüğü, veri çeşitliliği, model boyutu ve önceden eğitilmiş bir model kullanılıp kullanılmadığı belirleyicidir. Az verili bir işte hazır temsilleri uyarlamak yardımcı olabilir. Yine de birkaç örnekle alınan iyi eğitim puanı, gerçek dünyada güvenilir başarı kanıtı değildir. Ayrı ve temsil edici bir test kümesi gerekir.
Derin öğrenme kendi kendine düşünüyor mu?
Sinir ağı, öğrendiği parametrelerle matematiksel hesaplama yapar. “Öğrenme” burada ağırlıkların verideki hedefe göre ayarlanması anlamına gelir; bilinç veya insan düşüncesi kanıtı değildir. İnsan diline benzeyen bir yanıt üretmesi de yanıtın doğru, güncel veya gerekçelendirilmiş olduğunu garanti etmez.
Katman sayısı arttıkça model her zaman iyileşir mi?
Hayır. Daha çok katman, bazı karmaşık görevler için kapasite sağlayabilir; aynı zamanda eğitim zorluğu, gecikme ve aşırı uyum riskini artırabilir. Mimari, veri ve hesaplama bütçesi birlikte değerlendirilir. Daha küçük bir modelin yeterli olduğu yerde daha büyük ağ yalnızca maliyet ekleyebilir.
Sinir ağı ile insan beyni aynı şey mi?
Hayır. “Yapay sinir ağı” adı biyolojik sinir sisteminden esinlenmiştir, fakat yazılım düğümleri ile gerçek nöronların işleyişi aynı değildir. Yapay ağlar sayısal işlemler ve optimizasyonla belirli görevleri çözer. Beynin tüm yeteneklerini ve mekanizmalarını taklit ettiklerini söylemek yanıltıcı olur.
Derin öğrenme ne zaman gereksiz olabilir?
Açık bir iş kuralı yeterliyse, az sayıda yorumlanabilir değişkenle güçlü bir temel model kurulabiliyorsa veya gecikme ve bakım sınırları çok sıkıysa önce daha basit çözüm denenmelidir. Tablolu verilerde ağaç tabanlı yöntemler çoğu zaman güçlü adaylardır. Karar, moda sözcüklere göre değil, aynı test kümesindeki başarı ve toplam işletme maliyetine göre verilmelidir.
Modelin verdiği skor güven oranı mıdır?
Her zaman değil. Bir sınıf için yüksek skor, modelin o sınıfı diğerlerinden öne koyduğunu gösterir. Bu skorların gerçek olay sıklıklarıyla uyumu ayrıca kalibrasyonla ölçülmelidir. Eğitim dışı görüntülerde ağ yanlış cevap için bile yüksek skor verebilir. Kritik uygulamalarda belirsizlik, hata türleri ve gerektiğinde uzman incelemesi tasarlanmalıdır.
Sonuç
Derin öğrenme, çok katmanlı sinir ağlarıyla veriden görev için yararlı temsiller öğrenir. Temel akış; girdiyi katmanlardan geçirmek, tahmini gerçekle karşılaştırmak, kaybı hesaplamak ve ağırlıkları güncellemektir. Yararını gösteren şey katman sayısı veya etkileyici demo değil, yeni ve gerçekçi örneklerde tutarlı performanstır. Başlangıç için küçük bir problem seçin, basit bir referans model kurun ve veriyi dikkatle ayırarak sonuca bakın.
Kaynaklar ve ileri okuma
- Google Machine Learning Crash Course: Neural Networks — katmanlar, düğümler ve temel hesaplama.
- Google: Backpropagation — gradyanların geri yayılımı.
- Google: Overfitting — eğitim başarısı ve genelleme ayrımı.
- PyTorch: Automatic Differentiation — otomatik türev ve model eğitimi.