Crawl budget, yani tarama bütçesi, Google’ın bir sitede tarayabildiği ve taramak istediği URL kümesini anlatır. Bu, Search Console’da artırılabilen sabit bir günlük kota değildir. Google tarama kapasitesini sunucunun sağlığına, tarama talebini ise bilinen URL’lerin değeri ve güncelliğine göre ayarlar. Bir sayfanın taranması da otomatik olarak dizine alınacağı anlamına gelmez.
Birçok küçük WordPress sitesinde “crawl budget artırma” ilk SEO işi değildir. Yeni yazılar makul sürede bulunuyorsa, site haritası güncelse ve önemli sayfalar erişilebiliyorsa özel bir bütçe operasyonu gerekmeyebilir. Google’ın ileri düzey kılavuzu özellikle milyonlarca sayfalık, çok hızlı güncellenen veya “Keşfedildi, şu anda dizine eklenmedi” grubunda çok sayıda URL bulunan siteleri hedefler. Bu rehber önce gerçekten sorun olup olmadığını anlamayı, sonra URL çoğalması ve sunucu hatalarını güvenli sırayla çözmeyi gösterir.
Crawl budget tam olarak nedir?
Google iki unsurdan söz eder. Tarama kapasitesi sınırı, sunucuyu bunaltmadan açılabilecek bağlantı ve istek düzeyini belirler. Sunucu yavaşlıyor, sık sık 5xx ya da 429 yanıtı veriyorsa Google daha temkinli tarayabilir. Tarama talebi ise Google’ın URL’leri ne sıklıkla yeniden görmek istediğiyle ilgilidir. Bilinen URL sayısı, güncelleme sıklığı, kalite, alaka ve popülerlik bu talebi etkileyebilir. İkisinin birleşimi bir site için tarama bütçesi fikrini oluşturur.
Google’ın bu bağlamda “site”yi genellikle ana makine adı düzeyinde ele aldığını bilin: www.example.com ve shop.example.com ayrı değerlendirilebilir. Bu ayrım, alt alanlara bölünmüş büyük projelerde raporu yorumlarken önemlidir. Yine de alt alan açmak, otomatik olarak daha çok kaliteli tarama veya indeks anlamına gelmez; mimari kararını kullanıcı ve teknik ihtiyaçlara göre verin.
Küçük site ile büyük siteyi ayırın
Google’ın verdiği yaklaşık örnekler, haftalık değişen bir milyonun üzerinde benzersiz sayfa veya her gün değişen on binin üzerinde benzersiz sayfa gibi ölçeklerdir. Bunlar sert eşikler değildir; hızlı fikir vermek içindir. Birkaç yüz yazısı olan bir blog, önceliği içerik kalitesi, iç bağlantılar, erişim ve dizine ekleme raporuna vermelidir. Google, bin sayfadan küçük sitelerin çoğunda ayrıntılı Tarama İstatistikleri raporuyla uğraşmaya gerek olmayabileceğini de belirtir.
Buna karşılık geniş ürün katalogları, pazar yerleri, forumlar, etkinlik listeleri ve filtre kombinasyonlarıyla milyonlarca URL üreten siteler farklıdır. Burada Google’ın çok sayıda düşük değerli URL’yi tekrar tekrar istemesi yeni ve önemli ürün sayfalarının keşfini geciktirebilir. Sorun “Google neden daha fazla taramıyor?” diye sorulmadan önce “site hangi URL’leri üretiyor?” sorusuyla incelenmelidir.
Bu sitedeki içerik denetimimizde 551 yayımlanmış yazı vardı. Bu sayı tek başına tarama bütçesi sorunu kanıtlamaz; Search Console ve sunucu günlükleri incelenmeden buraya özgü bir darboğaz teşhisi konamaz. Aralıklı veritabanı erişim hatası ayrıca rapora girmişti: böyle bir altyapı sorunu varsa önce erişim güvenilirliğini çözmek, soyut bütçe hesabından daha acil olabilir.
Tarama, indeksleme ve sıralama farklı aşamalardır
Keşif, Google’ın bir URL’nin varlığını bağlantı veya site haritasından öğrenmesidir. Tarama, URL’ye istek gönderip içeriğini almasıdır. Dizine ekleme, içeriği değerlendirdikten sonra arama dizinine alma kararıdır. Sıralama ise uygun sorguda hangi sonucun nerede gösterileceğidir. İlk aşamadaki sorun, sonrakilerle karıştırılırsa yanlış çözümler seçilir.
Search Console’da “Keşfedildi, şu anda dizine eklenmedi” ifadesi, Google’ın URL’yi bildiğini fakat henüz taramamış olabileceğini anlatır. Bu durum tek başına kesin tarama bütçesi kanıtı değildir. “Tarandı, şu anda dizine eklenmedi” ise taramanın gerçekleştiğini gösterir; burada içerik değeri, kopya sayfalar, canonical seçimi veya başka indeksleme etkenleri düşünülmelidir. Bir URL’nin site haritasında olması da dizine alınacağını garanti etmez.
1. Önce veri toplayın: hangi URL’ler etkileniyor?
Teşhise üç listeden başlayın: yeni veya güncellenmiş önemli URL’ler, Search Console’da henüz taranmamış URL’ler ve Googlebot’un gerçekte istediği URL örnekleri. Birkaç URL’nin durumuna bakıp bütün site hakkında karar vermeyin. Örneğin yeni ürün sayfaları gecikiyor ama filtre URL’leri sık taranıyorsa URL envanteriyle ilgili bir hipotez oluşur. Tüm URL türleri yavaş ve 5xx artmışsa sunucu kapasitesi daha güçlü bir adaydır.
Search Console’daki Sayfa dizine ekleme raporunda etkilenen grupları, URL Denetimi aracında ise tekil sayfaların son tarama ve canonical verilerini inceleyin. Uygun mülke erişiminiz varsa Ayarlar → Tarama istatistikleri ekranında toplam istek, yanıt kodu, dosya türü, tarama amacı, bot türü ve ortalama yanıt süresi eğilimlerine bakabilirsiniz. Bu rapor kök alan veya alan adı mülklerinde bulunur; alt klasör düzeyindeki mülkte görünmeyebilir.
Tarama İstatistikleri raporundaki örnek URL listesi tüm isteklerin eksiksiz dökümü değildir. Kapsamlı URL bazlı analiz gerekiyorsa sunucu erişim günlükleri veya uygun log analiz sistemi gerekir. Logları incelerken Googlebot kimliğini doğrulamadan her “Googlebot” user-agent satırına güvenmeyin. İstek zamanlarını sunucu hata günlükleriyle eşleştirin; hız düşüşünün bot isteğinden önce mi sonra mı başladığını anlamaya çalışın.
2. Sunucu erişimi ve yanıt süresini düzeltin
Google, yavaşlayan sunucu veya artan 5xx ve 429 yanıtları gördüğünde taramayı azaltabilir. Bu yüzden önemli URL’lerin sık sık hata vermesi öncelikli teknik sorundur. Önce hatanın hangi şablonda, saatlerde ve hangi kodlarla oluştuğunu bulun. Veritabanı bağlantı limiti, yetersiz PHP işlem kapasitesi, önbellek sorunu veya geçici dağıtım hatası gibi nedenler farklı çözümler gerektirir.
“Daha yüksek sunucu paketi alın, bütçe artar” genel bir kural değildir. Google, site zaten hizmet kapasitesi sınırında taranıyorsa ek kaynakların işe yarayabileceğini; tarama talebi düşükse kapasite artışının tek başına istek yaratmayacağını belirtir. Bu ayrımı rapordaki eğilimle ve gerçek sunucu yüküyle doğrulayın. Sorunun ölçümü olmadan cache, CDN veya bot engeli açıp kapatmak yeni hatalar üretebilir.
Değişmeyen sayfalarda uygun HTTP önbellekleme ve 304 Not Modified yanıtı, Google’ın aynı içeriği gereksiz yeniden indirmesini azaltabilir. Ancak bunun için sunucu veya CDN’nin koşullu istekleri doğru karşılaması gerekir. 304’ü yanlış içerik için döndürmek güncellemelerin görülmesini geciktirebilir; uygulamadan sonra örnek URL’leri kontrol edin.
3. URL envanterini ve kopyaları sadeleştirin
Bir ürünün veya makalenin aynı içerikle onlarca URL’den açılması, tarama alanını büyütür. İzleme parametreleri, oturum kimlikleri, büyük/küçük harf farkı, HTTP/HTTPS varyantları ve iç bağlantılardaki tutarsızlıklar kopya URL’ler oluşturabilir. Önce tek bir tercih edilen kalıcı adres seçin. İç bağlantılar, site haritası, yönlendirmeler ve canonical etiketleri bu kararı desteklesin.
Canonical, arama motoruna bir tercih bildirir; URL’yi taramayı teknik olarak yasaklamaz. Gerçek kopyaları birleştirmek çoğu zaman doğru ilk adımdır. 301 yönlendirmeyi ise yalnızca kalıcı olarak taşınan veya aynı içeriğe karşılık gelen URL’de kullanın. Farklı öğeler gösteren sayfa 2’yi ilk sayfaya yönlendirmek ürünlerin erişimini kesebilir. Sayfalama ayrıntıları için pagination SEO rehberine bakın.
Önemli içeriğin değeri düşük varyantlardan ayrılması yalnızca bot için değildir. Kullanıcılar da daha temiz kategori, filtre ve arama deneyimi görür. Bu nedenle “tüm parametreleri kapatalım” yerine hangi URL’lerin gerçek arama niyeti taşıdığını belgeleyin.
4. Filtre kombinasyonlarında sonsuz URL alanını önleyin
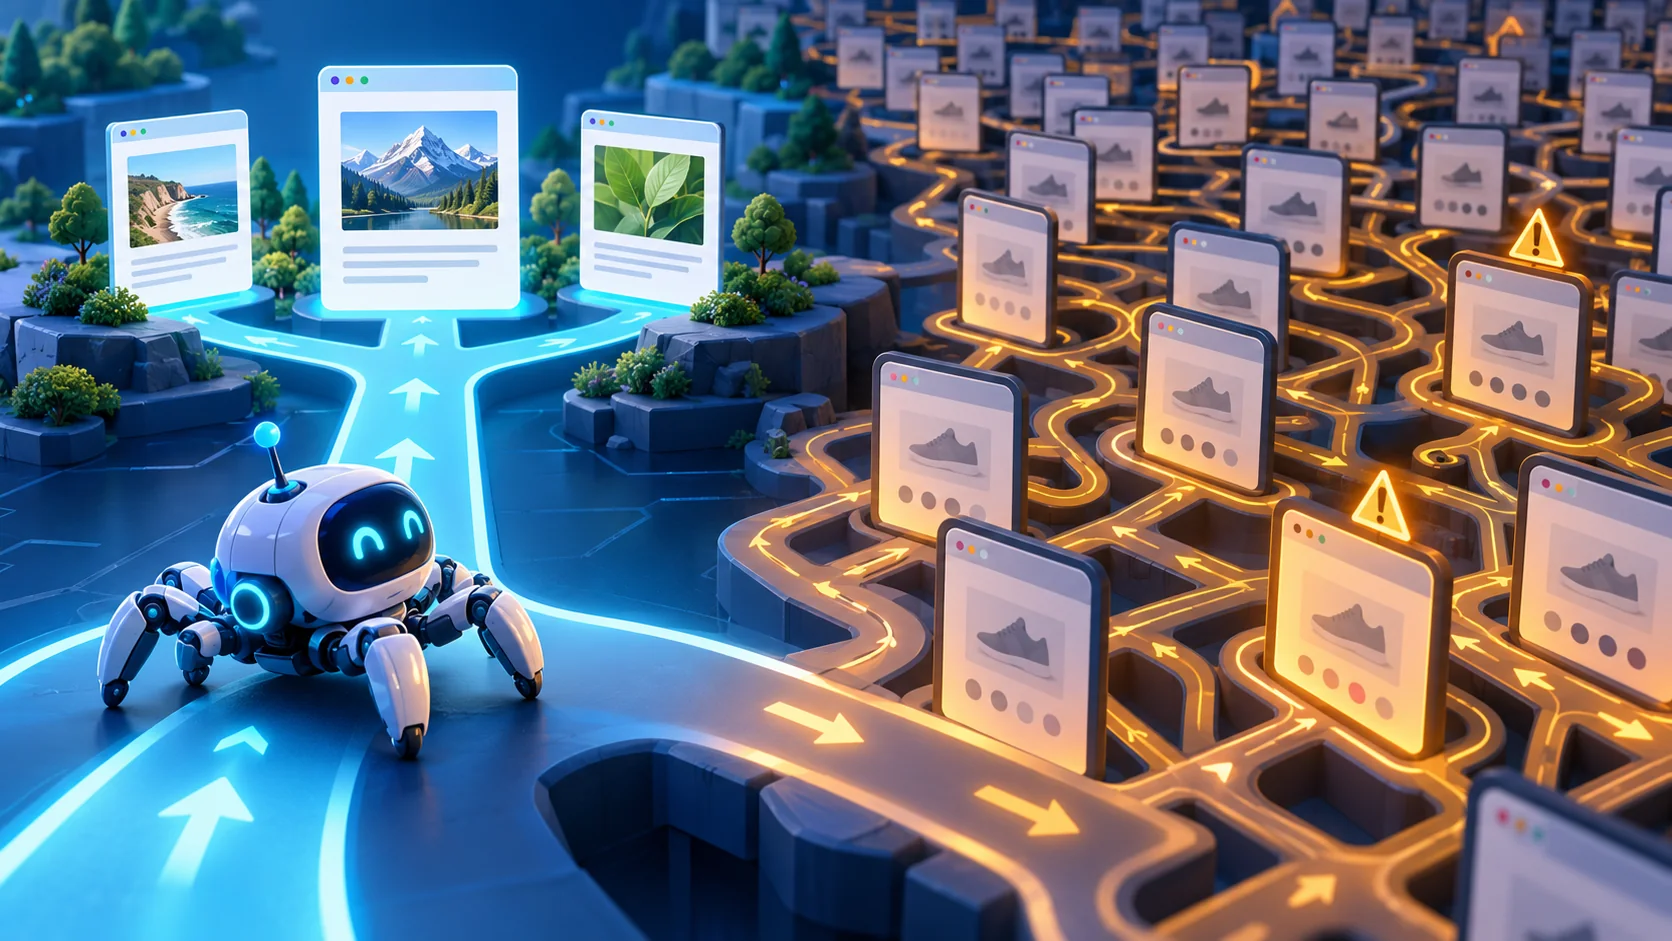
Bir mağazada renk, beden, marka, fiyat, sıralama ve stok filtreleri bağımsız URL parametreleri oluşturuyorsa kombinasyon sayısı hızla büyür. Örneğin ?renk=mavi&beden=m&sirala=fiyat ile parametre sırası değişmiş eşdeğer URL’ler veya sonuç vermeyen kombinasyonlar sürekli yeni adres gibi görünebilir. Google’ın fasetli gezinme kılavuzu bu sınırsız URL alanını gereksiz taramanın yaygın nedeni olarak açıklar.
Önce hangi filtreli sayfaların aramada gerçekten görünmesini istediğinizi seçin. Değerli ve küratörlü kategori sayfalarına sabit URL, açıklayıcı içerik ve iç bağlantı verin. Geri kalan gereksiz filtre kombinasyonlarının taranmasını kontrol etmek için uygun robots.txt kurallarını değerlendirin. Kuralları üretim ortamında uygulamadan önce önemli ürün ve kategori URL’lerini yanlışlıkla engellemediğini test edin.
Burada iki önemli nüans var. noindex taramayı engellemez; Google etiketi görebilmek için sayfayı istemelidir. robots.txt ile engellenmiş URL’deki noindex da görülemeyebilir. Ayrıca Google, gereksiz URL’leri engellediğinizde boşalan tüm istekleri başka sayfalara otomatik aktarmaz; kapasite sınırına dayanılmıyorsa böyle bir beklenti gerçekçi değildir. Ama gereksiz URL üretimini durdurmak yine de sunucu ve keşif açısından değerlidir.
5. Site haritasını ve iç bağlantıları tutarlı tutun
XML site haritasında aramada görünmesini istediğiniz erişilebilir ve kanonik URL’leri bulundurun. Silinmiş, yönlendirilmiş veya noindex sayfaları sürekli haritada tutmak gereksiz gürültüdür. lastmod tarihini yalnızca içerik gerçekten önemli ölçüde değiştiğinde doğru güncelleyin; her açılışta bütün tarihleri bugüne çekmek Google’ın bu işarete güvenini azaltabilir. Site haritası keşfe yardım eder, tarama veya indeks garantisi vermez.
Önemli sayfaları yalnızca site haritasına emanet etmeyin. Ana kategori, ilgili makale ve ürün bağlantıları HTML içinde bulunmalı. Yeni bir rehberin hiçbir ilgili sayfadan bağlantı almaması, onun keşfini yavaşlatabilir. İyi bağlantı metni kullanıcıya hedefin ne olduğunu anlatır. Site haritasının kurulumu ve Search Console gönderimi için site haritası rehberini kullanabilirsiniz.
6. Silinen ve taşınan URL’lerin yanıtlarını doğru verin
Kalıcı olarak silinen ve eşdeğeri olmayan bir sayfa uygun 404 veya 410 yanıtı verebilir. Her kaldırılmış URL’yi ana sayfaya yönlendirmek aranan içeriği karşılamaz ve yumuşak 404 sorununa yol açabilir. Gerçek bir eşdeğer varsa kalıcı yönlendirme anlamlıdır. Yönlendirme zincirleri, aynı sonucu almak için birden çok isteğe neden olur; iç bağlantıları son hedefe güncelleyin.
Geçici sunucu hatalarını kalıcı 404 gibi göstermeyin. Gerçek 5xx veya 429 dalgası tarama kapasitesini etkileyebilir. Bir sitede bu kodları “bot daha az gelsin” diye uzun süre üretmek risklidir; Google’ın sorun giderme rehberi birkaç günden uzun süren erişim sorunlarının dizin görünürlüğüne zarar verebileceğini belirtir. Acil aşırı yük yönetimi ayrı bir operasyon planı gerektirir.
7. WordPress için pratik kontrol sırası
- Temel erişimi ölçün: Anasayfa, kategori, yeni yazı ve bir görsel URL’sini giriş yapmadan açın. Aralıklı veritabanı veya 5xx hatası var mı?
- Search Console gruplarına bakın: Keşfedildi ama taranmadı ve tarandı ama indekslenmedi gruplarını ayrı inceleyin.
- Tarama İstatistiklerini değerlendirin: Uygun mülkte yanıt kodu, host durumu ve ortalama yanıt süresi eğilimini kontrol edin.
- URL kaynaklarını sayın: Yazılar, kategoriler, etiketler, arama, sıralama ve filtre parametrelerinden hangileri çok sayıda adres oluşturuyor?
- Bir örnek seçin: Önemli yeni yazı ve gereksiz filtre URL’sinin iç bağlantı, canonical ve robots durumunu karşılaştırın.
- Önce güvenli düzeltmeleri yapın: Bozuk bağlantı, sunucu hatası, yanlış site haritası ve kopya URL tutarsızlığını giderin.
- Sonuçları izleyin: Değişiklikten sonra önemli URL’lerin keşif süresi ve hata oranı nasıl değişti?
WordPress eklentileri her sitede aynı URL türlerini üretmez. Tema, e-ticaret eklentisi, arşiv ayarları ve filtre eklentisi birlikte incelenmelidir. Bir robots.txt kuralını şablon düzeyinde değiştirmek yüzlerce sayfayı etkileyebilir. Bu nedenle önce kuralın kapsadığı örnek URL listesini çıkarın; canlı siteye uyguladıktan sonra hem engellenmesi gereken hem de açık kalması gereken sayfaları doğrulayın.
Örnek teşhis: yeni makaleler geç keşfediliyor
Varsayalım bir haber sitesinde yeni makaleler birkaç gün sonra taranıyor. Önce bunların ana sayfa veya kategori üzerinden gerçek HTML bağlantısı alıp almadığını inceleyin. Güncel site haritasındaki adres ve lastmod doğru mu? Sunucu o tarihlerde hata vermiş mi? Aynı anda takvim, arama veya filtre şablonu binlerce gereksiz URL mi üretmiş? Bu soruların yanıtı olmadan “crawl budget düşük” demek teşhis değildir.
Tarama İstatistikleri raporunda isteklerin büyük kısmı görsel veya statik dosyalar olabilir; toplam isteği doğrudan makale taraması saymayın. Rapordaki dosya türü ve amaç kırılımını okuyun. Bir günlük düşüş de normal dalgalanma olabilir; eğilim, yayın ritmi ve önemli URL’lerin durumu birlikte değerlendirilmelidir.
Örnek teşhis: ürünler taranıyor ama dizine girmiyor
Ürün URL’sinin son tarama tarihi varsa problem yalnızca tarama kapasitesi olmayabilir. Kopya varyantlar, çok benzer açıklamalar, geçersiz canonical hedefi, stok dışı ve boş sayfalar veya içerik kalitesi incelenmelidir. Aynı ürünün farklı parametrelerle çok sayıda URL’si varsa tercih edilen URL ve iç bağlantı tutarlılığına bakın. Ancak farklı ürünleri tek canonical altında toplamayın.
Ürün kategorisindeki sayfalama da keşfi etkiler. Sonraki sayfanın gerçek bağlantısı yoksa derin ürünler bulunamayabilir. Bu durumda bot isteğini “artırmak” yerine bağlantı yolunu düzeltmek daha doğrudan çözüm olur. Ürün akışı kullanıyorsanız o akışın da geçerli ve güncel olduğunu kontrol edin.
Sık yapılan yanlışlar
- Her küçük siteye bütçe projesi açmak: Önce önemli sayfaların makul sürede taranıp taranmadığını ölçün.
- Noindex ile taramayı durduracağını sanmak: Bot etiketi okumak için URL’yi istemeye devam edebilir.
- Bütün URL’leri robots.txt ile kapatmak: Önemli içerik ve kaynakları da yanlışlıkla engelleyebilirsiniz.
- Site haritasını garanti görmek: Bu bir keşif işaretidir; indeks kararı ayrı aşamadır.
- Canonical’ı tarama yasağı sanmak: Google tercihi değerlendirir; kopya URL’ye isteği hemen kesmeyebilir.
- Sunucu hatasını içerik sorunu gibi yorumlamak: 5xx ve 429’ları önce teknik kayıtlarla doğrulayın.
Hangi belirtiye hangi ilk adım?
Yeni yazı hiç keşfedilmiyor: Yazının yayımlanmış, 200 yanıt veren ve erişime açık olduğunu kontrol edin. Ana sayfa veya kategori üzerinden bağlantısı var mı? Site haritasında doğru URL yer alıyor mu? İlk tarama günler sürebilir; tekil bir yeni yazıya bakarak sistemik bütçe sorunu sonucuna varmayın.
URL keşfedilmiş ama uzun süre taranmıyor: Bu durumu çok sayıda önemli URL’de görüyorsanız sunucu sağlığı, gereksiz URL hacmi ve bağlantı derinliğini birlikte inceleyin. Tarama İstatistikleri raporunda 5xx veya yanıt süresi artışı var mı? Filtre ve sıralama sayfaları isteklerin büyük bölümünü alıyor mu? Kaynak URL grubunu ayırmadan robots kuralı yazmayın.
URL taranmış ama indekslenmiyor: Tarama bütçesinden önce Google’ın seçtiği canonical adresi, sayfanın gerçek içeriğini ve yakın kopyaları inceleyin. Birkaç cümlelik birbirine benzeyen sayfalar için daha çok bot isteği temel sorunu çözmez. Gerekirse içerikleri genişletin, birbirinden ayırın veya kullanıcı için tek güçlü sayfada toplayın; yönlendirme kararını performans ve bağlantı verisiyle verin.
Bot istekleri artarken site yavaşlıyor: Hangi bot türü, hangi URL şablonu ve hangi yanıt kodu artmış belirleyin. Sunucu günlüğü, uygulama hatası ve önbellek verisini aynı saatlerde karşılaştırın. Hata üreten sorguyu düzeltmek, rastgele bot engellemesinden daha kalıcıdır. Erişim sorunu kritikse hosting ekibiyle kapasite ve geçici yük yönetimi planı oluşturun.
Sık sorulan sorular
Crawl budget sayısını Search Console’da görebilir miyim?
Tek bir kesin “kalan bütçe” sayacı yoktur. Tarama İstatistikleri raporu istek geçmişini, yanıtları ve host durumunu gösterir. Bunu URL dizine ekleme verisi ve gerekiyorsa erişim günlükleriyle birlikte yorumlayın.
Site haritasını yeniden göndermek bütçeyi artırır mı?
Hayır, otomatik artış beklemeyin. Güncel ve doğru site haritası önemli URL’lerin keşfine yardım edebilir. Google, yeniden tarama isteğinin anında tarama veya dizine ekleme garantisi vermediğini belirtiyor.
404 sayfalar tarama bütçesini boşa harcar mı?
Artık var olmayan sayfanın gerçek 404 yanıtı vermesi normaldir. Asıl inceleme, silinmiş URL’lerin hâlâ dahili bağlantılarda veya site haritasında tutulup tutulmadığı ve gereksiz yeni URL’ler üreten bir şablon olup olmadığıdır. Geçerli bir eşdeğer sayfa varsa uygun yönlendirme kullanın.
Daha hızlı hosting almak her zaman çözüm mü?
Sunucu kapasitesi gerçekten sınır oluşturuyorsa yardımcı olabilir. Talep düşükse daha hızlı sunucu tek başına daha fazla tarama oluşturmaz. Önce host durumu, yanıt süresi, hata oranı ve önemli URL’lerin tarama gecikmesini ölçün.
Robots.txt ile noindex arasındaki fark nedir?
robots.txt botun belirli URL’leri taramasını engelleyebilir. noindex ise taranabilen sayfada görülen bir indeksleme yönergesidir. Bot URL’ye erişemiyorsa noindex’i okuyamaz. Hangi URL’lerin arama sonuçlarında görünmesini istediğinizi belirlemeden bu yöntemleri karıştırmayın.
Kaynaklar ve ileri okuma