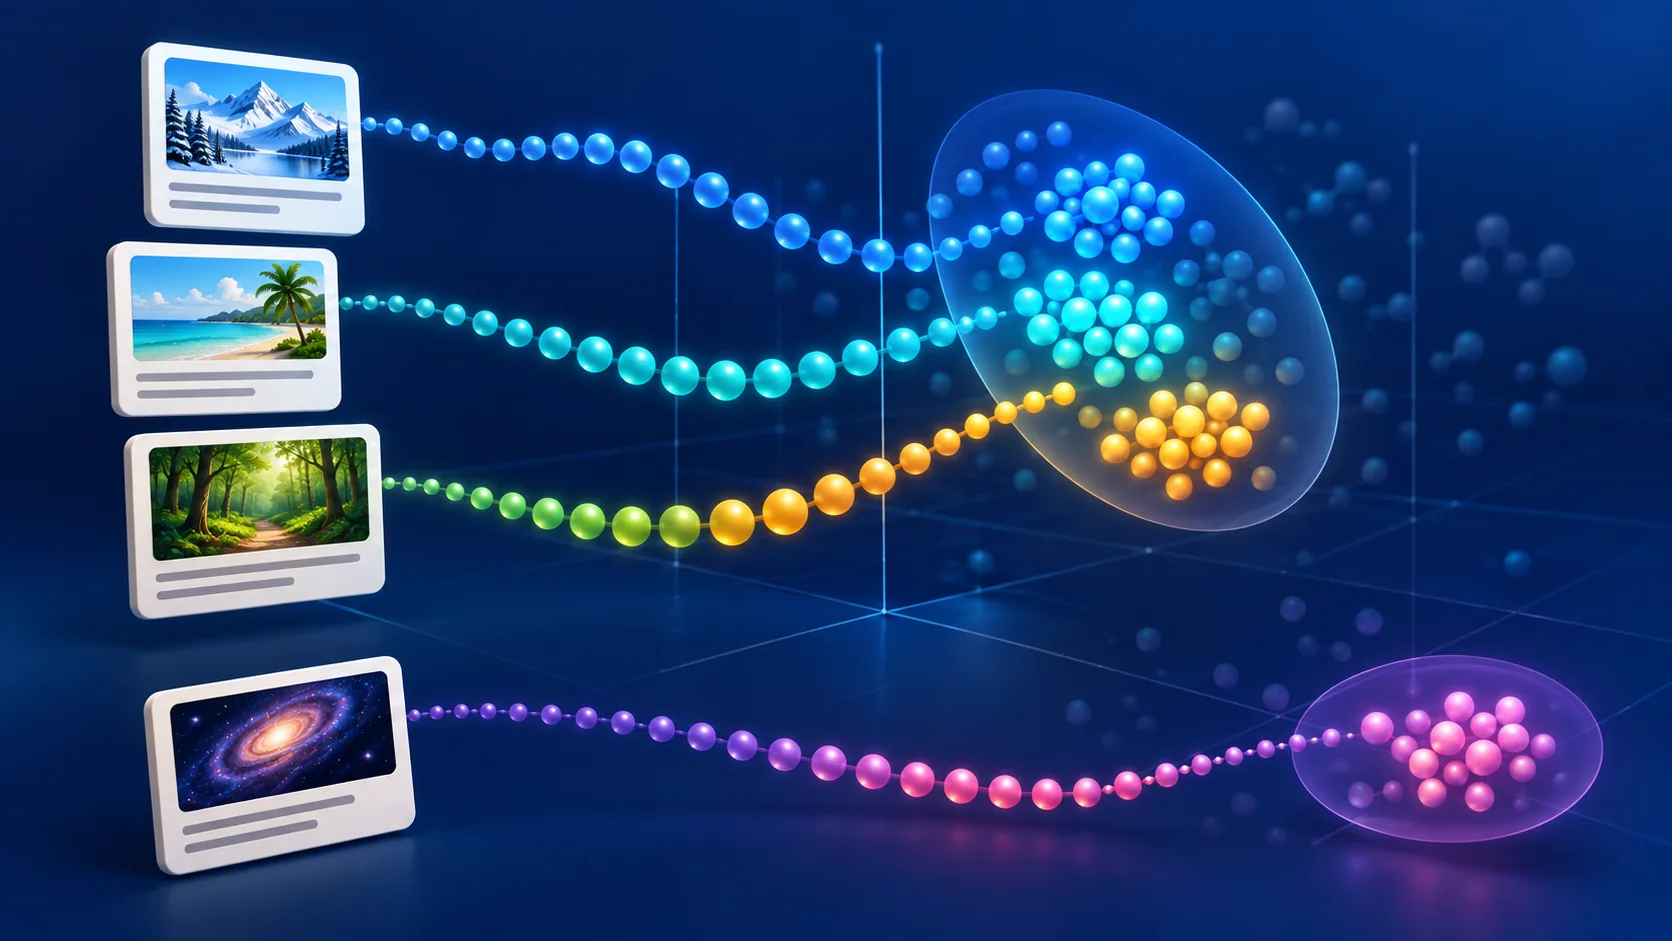
Embeddings, metin gibi bir girdiyi çok sayıda sayısal değerden oluşan bir vektöre dönüştürür. Bu değerler tek tek “konu etiketi” değildir; modelin öğrendiği ilişkiler içinde girdinin bir temsilidir. PHP projesinde en yaygın kullanım, kullanıcı “üyelik şifremi nasıl yenilerim?” diye yazdığında aynı sözcükleri içermeyen “hesap erişimini geri alma” belgesini de bulabilen anlamsal aramadır. Bu yakınlık yararlı bir sıralama sinyali sunar, fakat belgenin doğru veya güncel olduğunu ispatlamaz.
Bu rehberde önce embedding ile anahtar kelime aramasının farkını, ardından PHP sunucusundan vektör üretme, PostgreSQL ve pgvector ile saklama, sorgulama, yetki filtreleme ve kalite ölçme adımlarını ele alacağız. Kod parçaları mimariyi gösteren başlangıç örnekleridir; canlı sistemde kimlik doğrulama, hata yönetimi, veri saklama ve testleri tamamlamanız gerekir. Model adları ve sınırlar değişebildiği için yayına almadan önce bağlantı verilen resmi belgeleri kontrol edin.
Embedding nedir ve ne değildir?
Bir embedding modeli girdi metnini sabit boyutlu sayı dizisine çevirir. Örneğin “fatura adresini değiştirme” ve “ödeme bilgilerimdeki adresi güncelleme” farklı kelimeler kullansa da bağlamca yakın olabilir. Aynı modelle üretilmiş vektörler bir yakınlık ölçüsüyle karşılaştırılınca bu ilişki aranabilir hale gelir. Uzaklık, kullanıcının sorusuna yanıt verecek belgeyi bulmak için bir aday sıralamasıdır; bir hakikat testi, şifreleme yöntemi veya veritabanı yedeği değildir.
Vektördeki bir sayıyı “gizlilik”, bir başkasını “fatura” olarak okuyamazsınız. Model değişirse sayılar ve uzay değişebilir. Aynı uzunlukta iki vektörün farklı modellerden gelmesi onları anlamlı biçimde karşılaştırabileceğiniz anlamına gelmez. Bu yüzden model adı, sürüm, boyut ve indeksleme tarihi veri kaydının parçası olmalıdır. Bir uygulama yeni modele geçerken eski kayıtları ayrı tutmalı veya yeniden vektörleştirmelidir.
Embedding yalnızca metin için değildir; uygun modeller görsel veya başka veri türlerini de temsil edebilir. Fakat burada anlatılan text-embedding-3-small örneği metin araması içindir. Bir fotoğrafın piksellerini bu örnek API’ye doğrudan göndererek aynı semantik sonucu beklemeyin. Kaynağınız PDF ise önce içindeki metni çıkarın, bozuk sayfaları kontrol edin ve bağlamını koruyan parçalar oluşturun.
Anahtar kelime aramasından farkı
Klasik tam metin araması “iade süresi” ifadesini içeren dokümanı hızlıca bulabilir. Anlamsal arama ise “aldığım ürünü kaç gün içinde geri gönderebilirim?” sorusunu iade politikasıyla ilişkilendirebilir. Bununla birlikte tam eşleşme hâlâ değerlidir. Ürün kodu, hata mesajı, parça numarası ve özel isimlerde vektör araması yanlış yakınlık kurabilir. Sadece embedding kullanmak yerine anahtar kelime araması ile adayları birleştiren hibrit düzen, pek çok gerçek bilgi tabanı için daha sağlam bir başlangıçtır.
Örneğin destek sitesindeki “ERR_1042” hata kodu anlamsal modele genel bir bağlantı hatası gibi görünebilir. Tam metin araması kesin kodu kaçırmaz. Buna karşılık kullanıcı hata kodunu bilmiyorsa anlam yakınlığı doğru çözüm sayfasını öne çıkarabilir. İki yöntemin sonuçlarını körlemesine toplamak yerine test kümenizde hangi soru türünde hangisinin işe yaradığını ölçün. Aynı belge iki listede çıkarsa tekrarını kaldırın ve kaynak yetkisini koruyun.
PHP projesi için önce veri akışını tasarlayın
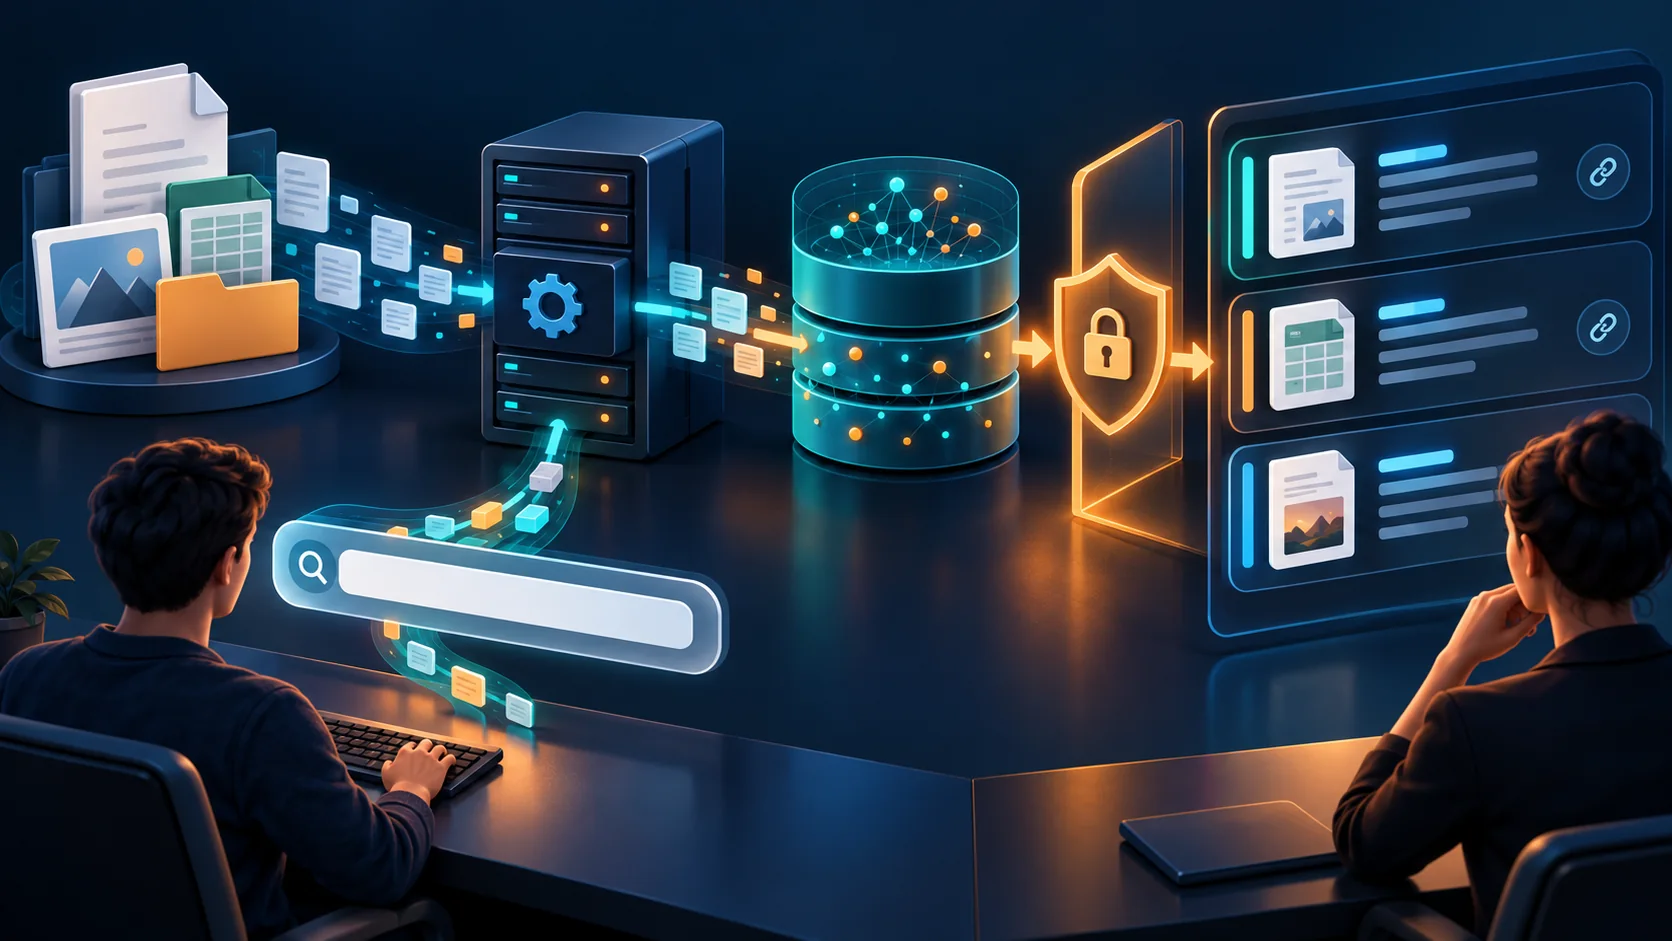
İndeksleme ve arama iki ayrı akıştır. İndekslemede belgeyi yetkili kaynaktan alır, metni çıkarır, temizler, anlamlı parçalara böler, her parçanın embedding’ini üretir ve metin ile kaynak bilgisini vektörün yanında saklarsınız. Aramada kullanıcı sorgusunu aynı modelle vektöre dönüştürür, erişim hakkı olan kayıtlar içinde en yakın parçaları bulur ve sonuçları bağlantılarıyla gösterirsiniz. Sorgu sırasında bütün belgeyi yeniden vektörleştirmek gereksiz maliyettir.
Bir parça kaydında en az belge kimliği, parça sırası, görünen metin, kaynak URL, tenant veya kullanıcı erişim kapsamı, içerik sürümü, embedding modeli ve boyutu bulunmalıdır. Belge silinince parçaları da kaldırılmalı. Metin güncellenince yalnızca yeni dosyanın eklenmesi eski parçaları gizlice indeks içinde bırakabilir; sürüm değiştirme veya atomik yeniden indeksleme planı gerekir. Kaynak bağlantısı olmadan dönen “benzer metin”, kullanıcının doğrulama yapmasını zorlaştırır.
Belgeleri yalnızca karakter sayısına göre körlemesine bölmeyin. Başlık ile altındaki açıklamayı mümkün olduğunca birlikte tutun. Çok uzun parçalar farklı konuları tek vektöre karıştırabilir; çok kısa parçalar ise soruya cevap verecek bağlamı kaybeder. Önce küçük bir belge kümesinde birkaç parça boyutu deneyin. Sayfa numarası, bölüm başlığı ve kaynak tarihini metaveri olarak saklamak hem arama hem de sonuç sunumu için yararlıdır.
OpenAI Embeddings API ile vektör üretme
OpenAI’nin güncel embeddings rehberi örnek başlangıç modeli olarak text-embedding-3-small gösteriyor. Varsayılan vektör uzunluğu 1.536; text-embedding-3-large için 3.072. dimensions parametresiyle daha kısa çıktı seçilebilir, ancak bunu veri tabanı şemasına ve kalite testine birlikte yansıtın. Sayıları ve fiyatı kalıcı varsayım yapmayın. API anahtarını yalnızca sunucuda tutun; istemci tarafı JavaScript veya herkese açık depoya yazmayın.
Aşağıdaki PHP örneği bir metin parçasını gönderir. Ortam değişkeninden anahtar okur, HTTP hatasını kontrol eder ve ilk vektörü alır. Üretimde zaman aşımı, yeniden deneme, oran sınırı ve günlüklerde hassas içeriği saklamama kuralları ayrıca gerekir. Kodun çalışması için PHP cURL uzantısı ve geçerli hesap erişimi gerekir; bu yazıdan gerçek API isteği yapılmadı.
<?php
$text = 'Şifremi nasıl yenilerim?';
$key = getenv('OPENAI_API_KEY');
if (!$key || trim($text) === '') {
    throw new RuntimeException('Anahtar veya metin eksik');
}
$body = json_encode([
    'model' => 'text-embedding-3-small',
    'input' => $text,
], JSON_THROW_ON_ERROR);
$ch = curl_init('https://api.openai.com/v1/embeddings');
curl_setopt_array($ch, [
    CURLOPT_POST => true,
    CURLOPT_HTTPHEADER => [
        'Authorization: Bearer ' . $key,
        'Content-Type: application/json',
    ],
    CURLOPT_POSTFIELDS => $body,
    CURLOPT_RETURNTRANSFER => true,
    CURLOPT_TIMEOUT => 30,
]);
$response = curl_exec($ch);
$status = curl_getinfo($ch, CURLINFO_HTTP_CODE);
if ($response === false || $status < 200 || $status >= 300) {
    throw new RuntimeException('Embedding isteği başarısız');
}
$data = json_decode($response, true, 512, JSON_THROW_ON_ERROR);
$vector = $data['data'][0]['embedding'] ?? null;
if (!is_array($vector) || count($vector) !== 1536) {
    throw new RuntimeException('Beklenmeyen vektör boyutu');
}
curl_close($ch);
Bu kodun count($vector) !== 1536 denetimi, varsayılan text-embedding-3-small seçimine özgüdür. Model veya dimensions değeri değişirse beklenen boyutu da güncelleyin. Başarısız isteklerde anahtarı veya tam kullanıcı metnini hata mesajına eklemeyin. API yanıtındaki kullanım metaverisini maliyet gözlemi için ayrı ve sınırlı günlükleyebilirsiniz.
Vektörü PostgreSQL ve pgvector ile saklama
PostgreSQL kullanıyorsanız pgvector uzantısı vektör sütunu ve mesafe operatörleri sağlar. Her hosting ortamında uzantıyı kurma yetkisi olmayabilir; önce veritabanı sürümünü ve sağlayıcı desteğini doğrulayın. Aşağıdaki şema kavramsal bir başlangıçtır. Tenant kimliği ve belge sürümü gerçek yetki modelinize göre şekillenmelidir. Örnekteki 1.536 boyut seçtiğimiz embedding modeliyle eşleşir.
CREATE EXTENSION IF NOT EXISTS vector;
CREATE TABLE document_chunks (
  id bigserial PRIMARY KEY,
  tenant_id bigint NOT NULL,
  document_id bigint NOT NULL,
  chunk_no integer NOT NULL,
  source_url text NOT NULL,
  body text NOT NULL,
  model_name text NOT NULL,
  embedding vector(1536) NOT NULL,
  UNIQUE (document_id, chunk_no, model_name)
);
Gerçek uygulamada source_url güvenli bir iç adres veya yetkili bağlantı olmalıdır; kullanıcının girdiği keyfi URL’yi doğrudan kaynak kabul etmeyin. İçerik sürümü, oluşturma tarihi ve silinme durumu da eklenebilir. Aynı kayda farklı boyutta vektör koyamazsınız. Model geçişinde yeni sütun, yeni tablo veya ayrı indeks kullanıp sonuçları karşılaştırmak daha güvenlidir. Her değişiklikten sonra eski kayıtları kontrollü biçimde temizleyin.
Benzerlik sorgusu ve mesafe ölçüsü
pgvector’da <=> operatörü kosinüs mesafesidir; küçük değer daha yakın vektör anlamına gelir. Kullanıcı sorgusunu da belgelerle aynı model ve boyutla vektörleştirdikten sonra aşağıdaki gibi sıralayabilirsiniz. Tenant filtresi örneğe özellikle eklenmiştir. LIMIT değeri ürün ihtiyacına göre seçilir; yüzlerce sonucu döndürüp ön yüzde saklamak erişim kontrolü değildir.
SELECT document_id, chunk_no, source_url, body,
       embedding <=> $1::vector AS distance
FROM document_chunks
WHERE tenant_id = $2
  AND model_name = 'text-embedding-3-small'
ORDER BY embedding <=> $1::vector
LIMIT 5;
PHP tarafında vektör parametresini pgvector kitaplığının Vector türüyle veya doğrulanmış sayısal diziden oluşturulan pgvector metin biçimiyle bağlayın. pg_query_params ya da hazırlanan sorgu kullanın; kullanıcı metnini veya tenant kimliğini SQL dizesine birleştirmeyin. Resmi pgvector PHP paketi Vector nesnesiyle ekleme ve yakın komşu arama örnekleri içerir. Kullandığınız PHP sürümü ve paket sürümüne uygun çağrıyı belgede doğrulayın.
Saf PHP ve PgSql uzantısı kullanan bir projede arama çağrısı aşağıdaki iskeletle bağlanabilir. Önce composer require pgvector/pgvector paketini kurun. $vector bir önceki API çağrısından gelen sorgu vektörüdür; $tenantId ise kullanıcıdan serbest metin olarak değil, doğrulanmış oturumdan alınmalıdır.
<?php
require 'vendor/autoload.php';
$tenantId = 42; // Örnekteki yetkili tenant kimliği
$db = pg_connect(getenv('DATABASE_URL'));
if (!$db) { throw new RuntimeException('DB bağlantısı yok'); }
$queryVector = new \Pgvector\Vector($vector);
$sql = 'SELECT document_id, source_url, body
        FROM document_chunks
        WHERE tenant_id = $2
        ORDER BY embedding <=> $1::vector
        LIMIT 5';
$result = pg_query_params($db, $sql, [$queryVector, $tenantId]);
if ($result === false) {
    throw new RuntimeException('Arama sorgusu başarısız');
}
$rows = pg_fetch_all($result) ?: [];
Bu örnek bağlantı ve sorgu hatasını kullanıcıya ayrıntılı veritabanı metni olarak sunmaz. Gerçek uygulamada tenant filtresine ek olarak belge düzeyindeki yetkileri de uygulayın; bazı parçalar aynı tenant içinde yalnızca belirli rollere açık olabilir. Ayrıca uzak veritabanına bağlantı, sertifika ve sır yönetimini kendi ortamınıza göre kurun. Vektör aramasını bir sayfaya eklemek için yalnızca SQL çalıştırmak yeterli değildir.
İlk prototipte küçük bir veri kümesi için tam yakın komşu araması yeterli olabilir. pgvector varsayılan olarak kesin arama yapar. Veri büyüdükçe HNSW veya IVFFlat gibi yaklaşık indeksler hızı artırabilir; bunun karşılığında bazı doğru adaylar kaçabilir. Önce doğru sonuçları ölçün, ardından indeks ve ayarların hız ile geri getirme kalitesine etkisini karşılaştırın. Erken optimizasyon, eksik yetki filtresi veya yanlış model boyutunu telafi etmez.
CREATE INDEX document_chunks_tenant_idx
ON document_chunks (tenant_id);
CREATE INDEX document_chunks_embedding_hnsw
ON document_chunks USING hnsw (embedding vector_cosine_ops);
HNSW örneği pgvector’ın kosinüs mesafesi için belgelediği işlem sınıfını kullanır. Ancak çok kiracılı sistemde yaklaşık indeks ile WHERE tenant_id filtresinin etkileşimi sonuç sayısını ve geri çağırmayı değiştirebilir. pgvector belgeleri filtrelemenin indeks taramasından sonra uygulanabildiğini ve gerekirse iterative scan, kısmi indeks veya bölümlendirme düşünülmesi gerektiğini açıklar. Kullanıcının başka tenant’a ait veriyi görmemesi uygulama ve veritabanı yetki kontrolüyle ayrıca güvenceye alınmalıdır.
Arama sonucunu okura nasıl sunmalı?
Vektör araması bir mesafe ve metin parçası döndürür. Kullanıcıya sadece “0,24 benzerlik” göstermek açıklayıcı değildir. Belge başlığı, ilgili kısa bölüm, tarih ve kaynağa giden doğru bağlantıyı gösterin. Sonuç parçasını bağlamından koparıp kesin cevap gibi sunmayın. Uzun belge için ilgili bölüme giden bağlantı ve çevre paragraf yararlı olabilir. Gizli alanları arama önizlemesinde bile sızdırmayın.
Birden fazla parça aynı belgeden geldiyse sonuç ekranında belgeyi tek kez göstermek isteyebilirsiniz. Bunun için en yakın parçayı seçmek, birkaç parçayı birleştirmek veya belge düzeyinde yeniden sıralamak mümkündür. Ancak çok parçayı art arda eklemek cevabı yanıltabilir; bölüm sırası ve kaynak konumu korunmalıdır. Arama çıktısında erişim hakkı ve sürüm kontrolünü tekrar uygulayın. Sonuçları önbelleğe alıyorsanız tenant ve yetki değiştiğinde önbelleği de geçersiz kılın.
RAG ile embedding arasındaki ilişki
Retrieval augmented generation, yani RAG, bir üretken modelin yanıtından önce ilgili kaynakları arayıp bağlama ekleyen düzendir. Embedding bu arama aşamasında kullanılabilir; RAG’in tamamı değildir. Belge alımı, parçalama, erişim filtresi, kaynak gösterme, yanıt üretme ve değerlendirme de gerekir. Büyük dil modeli rehberindeki üretim mantığıyla birlikte düşünün: yakın belge bulunsa bile model onu yanlış okuyabilir veya kaynağın söylemediği bir cümle kurabilir.
RAG için önce aramanın doğru parçayı bulup bulmadığını ayrı ölçün. Yanıt hatalıysa her zaman “daha iyi prompt” çözüm değildir; doğru kaynak hiç gelmemiş olabilir. Diğer yönde de arama iyi olsa bile yanıt modeli kaynak dışı bilgi ekleyebilir. Kaynağa dayalı yanıt isteyin, alıntı veya bağlantı sağlayın ve bilinmeyen soruda “bilmiyorum” yolunu açık tutun. Kullanıcının erişemeyeceği bir belgeyi modele bağlam olarak vermeyin.
Parçalama, tekrar ve güncelleme sorunları
Tekrarlanan sayfalar arama sonucunu aynı içerikle doldurabilir. İndeksleme öncesi belge kimliği ve içerik özetiyle tekrarları tespit edin. Bir ürünün eski ve yeni sürüm talimatları birlikte varsa güncel sürümü metaveriyle öne çıkarın, eskisini gerekirse arşivde tutun. Tarih tek başına yeterli olmayabilir; belge sahibi veya yayın iş akışı “geçerli” durumunu belirtmelidir. Embedding güncelliği kendiliğinden anlamaz.
PDF’den çıkarılan metinde tablo sırası bozulabilir, sütunlar birbirine karışabilir ve başlıklar kaybolabilir. Bu tür bozuk parçaları vektörleştirirseniz yakınlık araması düzgün olmayan veriyi etkili biçimde bulur. Önce örnek belgeyi insan gözüyle inceleyin. Parça boyutunu değiştirirken aynı test sorularında doğru kaynağın ilk kaç sonuçta geldiğini karşılaştırın. Tek bir “ideal 500 karakter” kuralı her içerik türü için çalışmaz.
Yeni model veya boyuta geçişte eski ve yeni indeksleri bir süre paralel tutup aynı soruları karşılaştırın. Veritabanında model adı ve boyut metaverisini tutmak karışmayı önler. Geçiş tamamlanınca uygulama sorgusunu yeni indekse çevirin, eksik kayıt olup olmadığını sayın ve geri alma yolu bırakın. Doğrudan var olan vektör sütununu değiştirmek geçmiş sorgu kalitesi hakkında karşılaştırma olanağını kaybettirebilir.
Güvenlik ve gizlilik: vektörler anonim değildir
Embedding sayılardan oluştuğu için verinin gizli olmadığı varsayılmamalıdır. Vektörler içerikle ilişkili bir temsil taşır; asıl metin ve metaveri de çoğu sistemde birlikte saklanır. Kişisel bilgileri üçüncü taraf API’ye göndermeden önce veri akışını, sağlayıcı koşullarını ve kurum politikalarını değerlendirin. Gereksiz kişisel alanları temizleyin; fakat temizleme metnin anlamını bozuyorsa kullanım senaryosunu yeniden düşünün. Yalnızca “vektör saklıyorum” demek mahremiyet çözümü değildir.
Çok kullanıcılı aramada erişim filtresini yalnızca ekranda uygulamayın. Yetkisiz sonuç sunucudan hiç dönmemeli. Kullanıcı hesabı devre dışı kaldığında veya belge paylaşımı değiştiğinde indeks erişimi de değişmelidir. Kaynak URL’si tahmin edilebilir olsa bile içerik yetkisi ayrıca kontrol edilmelidir. Loglara ham sorgu ve belge parçası yazmak veri saklama yüzeyini genişletir; ölçüm için gerekli asgari alanları tutun.
Sonuç kalitesini nasıl ölçersiniz?
İlk test için gerçek kullanıcı sorularından küçük ama çeşitli bir küme oluşturun. Her soru için “doğru kaynaklar” listesini bir uzmanla işaretleyin. Doğru belgenin ilk 1, 3 veya 5 sonuçta bulunma oranını ölçün. Anahtar kelime araması, saf vektör araması ve hibrit aramayı aynı sorularda karşılaştırın. Sadece ortalama skorla karar vermeyin; tam ürün kodu, eş anlamlı ifade, eski belge, erişim engelli belge ve cevapsız soru gibi zor örnekleri ayrı görün.
Yanlış olumlu sonuçları da izleyin. Bir belge vektör uzayında yakın olsa da sorunun cevabını içermeyebilir. Örneğin fatura iptali ile abonelik iptali benzer kelimeler kullanır ama işlem farklıdır. Arama sonucunda güven eşiği uygulayacaksanız evrensel bir sayı seçmek yerine kendi verinizde yanlış olumlu ve kaçırılan doğru sonuç dengesiyle belirleyin. İndeks veya model değiştikçe eşik yeniden ayarlanmalıdır.
Gecikme ve maliyet de kalite ölçümünün parçasıdır. Belge başına embedding üretimi, sorgu başına API çağrısı, veritabanı depolaması ve indeks belleği maliyetini ayrı izleyin. Tekrar eden belgeyi yeniden işlemekten kaçının. Ancak sırf maliyet için önemli paragrafları atlamak arama başarısını düşürür. Gerçek kullanıcıya gösterilecek ürün için doğruluk, yetki ve yanıt süresini birlikte değerlendirin.
Yayın öncesi kısa uygulama listesi
- Belge kaynağını, sürümünü ve erişim sahibini belirleyin.
- Metin çıkarma ve parça sınırlarını gerçek örneklerde gözden geçirin.
- İndeks ve sorgu için aynı embedding modeli ve boyutu kullanın.
- API anahtarını sunucuda tutun, metin ve vektör için saklama kuralı yazın.
- Tenant ve belge yetkisini sorgu ile sonuç açma aşamalarında doğrulayın.
- Kesin aramayla temel kaliteyi ölçün, yaklaşık indeksi sonra değerlendirin.
- Kaynak bağlantısı ve belge tarihini kullanıcıya gösterin.
- Model veya içerik değişince yeniden indeksleme ve geri alma planı uygulayın.
Sık sorulan sorular
Embedding bir metnin doğru olduğunu söyler mi?
Hayır. Vektör yakınlığı yalnızca belirli model ve ölçüye göre benzerlik sinyalidir. Yanlış bilgi içeren iki metin birbirine yakın olabilir. Kaynağın güvenilirliğini, tarihini ve iddiasını ayrı değerlendirin.
Her PHP sitesi için vektör veritabanı gerekir mi?
Hayır. Az sayıda belge ve basit arama gereksiniminde klasik tam metin araması yeterli olabilir. Önce kullanıcı sorularını ve mevcut aramanın eksiklerini belirleyin. Semantik aramanın ölçülür katkısı varsa vektör dizinini ekleyin.
Farklı embedding modellerinin vektörleri karıştırılabilir mi?
Genellikle hayır. Aynı boyutta olsalar bile farklı modellerin vektör uzayları karşılaştırılabilir kabul edilmemelidir. Model değişiminde belgeleri ve sorguları aynı yeni modele taşıyın, kaliteyi yeniden ölçün.
Vektör araması neden yanlış belgeyi getiriyor?
Neden parça sınırı, bozuk PDF metni, eski sürüm, eş anlamlılık, yakın ama farklı konu veya yetersiz erişim filtresi olabilir. Önce birkaç gerçek soruda dönen parçaları ve kaynaklarını elle inceleyin; sonra model, parçalama ve hibrit arama seçeneklerini karşılaştırın.
Kaynaklar ve ileri okuma