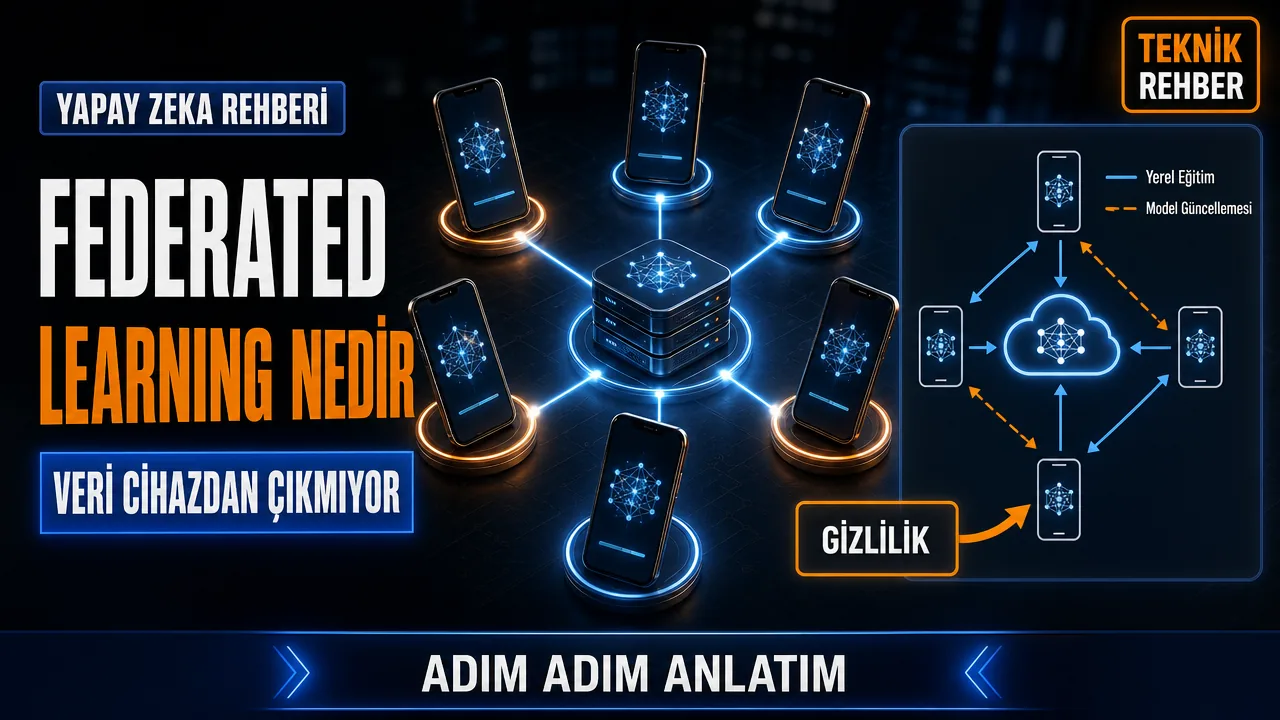
Federated Learning nedir? Federated Learning (Türkçe kullanımıyla federe öğrenme veya merkezi olmayan öğrenme), bir yapay zeka modelinin eğitim verisini tek bir merkezi sunucuda toplamadan, verinin bulunduğu telefon, tarayıcı veya hastane sunucusu gibi cihazlarda yerinde eğitilmesini ve yalnızca öğrenilen model güncellemelerinin merkezi bir sunucuda birleştirilmesini sağlayan bir makine öğrenmesi yaklaşımıdır. Google’ın 2017’de Gboard klavyesinin kelime tahmini için yayınladığı araştırmayla popülerleşen bu yöntem, 2026 itibarıyla hem büyük teknoloji şirketlerinin hem de sağlık, finans gibi gizliliğin kritik olduğu sektörlerin gündemindeki en önemli gizlilik-korumalı yapay zeka tekniklerinden biri olmaya devam ediyor.
Federated Learning Nedir, Klasik Eğitimden Farkı Ne?
Geleneksel bir yapay zeka modelini eğitirken, genellikle binlerce hatta milyonlarca kullanıcıdan toplanan veri tek bir merkezi sunucuya veya veri merkezine aktarılır ve eğitim orada yapılır. Bu yaklaşım güçlü hesaplama kaynaklarından tam olarak yararlanmayı kolaylaştırsa da, kullanıcı verisinin şirketin sunucularına taşınmasını gerektirir; bu da özellikle sağlık kayıtları, kişisel mesajlar veya klavye kullanım alışkanlıkları gibi hassas verilerde ciddi bir gizlilik riski oluşturur.
Federe öğrenmede ham eğitim örnekleri katılımcıda kalacak şekilde tasarım yapılır; paylaşılan ağırlıklar veya güncellemeler yine bilgi taşıyabilir. FedAvg, yerel eğitim sonrasındaki model ağırlıklarını örnek sayısına göre birleştirebilir; ağırlık farkı ile gradyan aynı kavram değildir. Gizlilik için ek protokoller ve tehdit modeli gerekir.
Federated Learning ile On-Device AI Arasındaki Fark Nedir?
Bu iki kavram sık karıştırılıyor ama farklı aşamaları ifade ediyor. On-device AI (yerel yapay zeka), zaten eğitilmiş bir modelin çıkarım (inference) aşamasının cihaz üzerinde, internete gitmeden çalıştırılmasıdır. Federated Learning ise modelin eğitim (training) aşamasının, verinin cihazda kalacak şekilde dağıtık olarak yürütülmesidir. Bir cihaz hem on-device AI hem de federated learning’e aynı anda katılabilir: model cihazda çalışır (inference) ve aynı zamanda cihazdaki yeni verilerle küçük güncellemeler üretip bu güncellemeleri sunucuyla paylaşır (federated training). Ayrıca Cloud AI (bulut yapay zeka) yaklaşımı eğitim veya çıkarımın bulutta yapılmasını ifade edebilir; hibrit sistemler de mümkündür.
Federated Learning Nasıl Çalışır? Adım Adım Süreç
- Model dağıtımı: Merkezi sunucu, güncel model ağırlıklarını katılımcı cihazlara (telefonlar, tarayıcılar, hastane sunucuları) gönderir.
- Yerel eğitim: Her cihaz, kendi yerel verisiyle (örneğin kullanıcının yazdığı kelimeler) modeli birkaç epoch boyunca eğitir. Bu sırada ham veri cihazdan hiç çıkmaz.
- Güncelleme paylaşımı: Cihaz, yalnızca eğitim sonucunda oluşan model güncellemesini (gradyan veya ağırlık farkını) sunucuya gönderir.
- Toplu birleştirme (aggregation): Sunucu, genellikle “Federated Averaging” (FedAvg) adı verilen bir algoritma ile binlerce cihazdan gelen güncellemeleri ağırlıklı ortalamasını alarak birleştirir.
- Model güncelleme ve tekrar: Yeni birleşik model bir sonraki turda tekrar cihazlara dağıtılır ve süreç, model yeterince iyileşene kadar tekrarlanır.
Basit Bir Federated Averaging Örneği
Aşağıdaki Python örneği, gerçek bir üretim sistemi olmasa da FedAvg algoritmasının temel mantığını -yani birden fazla cihazdan gelen model ağırlıklarının nasıl ortalandığını- basitçe göstermek için yazılmıştır:
import numpy as np

def federated_average(cihaz_agirliklari: list[np.ndarray], veri_sayilari: list[int]) -> np.ndarray:
    """
    cihaz_agirliklari: her cihazın yerel eğitim sonrası model ağırlık vektörü
    veri_sayilari: her cihazın yerel veri örneği sayısı (ağırlıklandırma için)
    """
    toplam_veri = sum(veri_sayilari)
    birlesik_agirlik = np.zeros_like(cihaz_agirliklari[0])

    for agirlik, n in zip(cihaz_agirliklari, veri_sayilari):
        birlesik_agirlik += agirlik * (n / toplam_veri)

    return birlesik_agirlik

# Örnek: 3 telefon, farklı miktarda yerel veriyle eğitim yaptı
cihaz_1 = np.array([0.42, 0.18])
cihaz_2 = np.array([0.39, 0.22])
cihaz_3 = np.array([0.45, 0.15])

yeni_model = federated_average(
    [cihaz_1, cihaz_2, cihaz_3],
    veri_sayilari=[120, 340, 75],
)
print(yeni_model)
Federated Learning Kurmanın Pratik Yolu: Flower Framework Örneği
Sıfırdan bir federated learning altyapısı yazmak yerine, açık kaynaklı Flower (flwr) gibi çerçeveler kullanmak çok daha pratik. Flower, PyTorch veya TensorFlow ile yazılmış bir modeli, gerçek ağ üzerinden birden fazla “istemci” arasında koordine etmeyi kolaylaştırıyor. Aşağıdaki basitleştirilmiş örnek, bir istemcinin Flower ile nasıl tanımlandığını gösteriyor:
import flwr as fl

class YerelIstemci(fl.client.NumPyClient):
    def __init__(self, model, yerel_veri):
        self.model = model
        self.yerel_veri = yerel_veri

    def get_parameters(self, config):
        return self.model.get_weights()

    def fit(self, parameters, config):
        self.model.set_weights(parameters)
        self.model.fit(self.yerel_veri, epochs=1)
        return self.model.get_weights(), len(self.yerel_veri), {}

    def evaluate(self, parameters, config):
        self.model.set_weights(parameters)
        kayip, dogruluk = self.model.evaluate(self.yerel_veri)
        return kayip, len(self.yerel_veri), {"dogruluk": dogruluk}

# Bu sınıf eğitim mantığını gösterir; güncel Flower uygulamasına ayrıca bağlanmalıdır.
Bu sınıf tamamlanmış bir uygulama değildir: model ve veri tanımları, sunucu, istemci başlatma ve güvenli ağ kurulumu eksiktir. start_numpy_client eski API olup kullanımdan kaldırılmıştır; yeni projede güncel Flower ClientApp/ServerApp akışını izleyin.
Federated Learning Türleri Nelerdir?
Federated Learning tek bir yöntem değil, veri yapısına göre değişen birkaç alt kategoriye ayrılıyor:
Yatay Federated Learning (Horizontal FL)
En yaygın kullanılan türdür. Farklı cihazlar veya kurumlar aynı özellik kümesine (örneğin aynı tür sağlık ölçümlerine) sahip ama farklı kullanıcılara ait veriye sahiptir. Google Gboard örneği tam olarak bu kategoriye girer: her telefon aynı türde veri (yazılan metin) üretir, ancak kullanıcılar farklıdır.
Dikey Federated Learning (Vertical FL)
Bu türde katılımcılar aynı kullanıcı kitlesine sahiptir ama farklı özellik kümelerine erişebilir. Örneğin bir banka ve bir e-ticaret şirketi, aynı ortak müşterilerin farklı yönlerini (biri finansal geçmişini, diğeri alışveriş alışkanlıklarını) bilebilir; vertical FL bu iki farklı veri kümesini, ham veriyi paylaşmadan ortak bir model eğitmek için birleştirir.
Federated Transfer Learning
Katılımcıların hem kullanıcı kitlesi hem de özellik kümesi büyük ölçüde farklı olduğunda kullanılır. Bu durumda önce genel bir model transfer öğrenme teknikleriyle uyarlanır, ardından federated learning süreciyle ince ayar yapılır. Genellikle veri örtüşmesinin çok az olduğu, çok sayıda farklı kurumun katıldığı senaryolarda tercih edilen, görece daha karmaşık bir yöntemdir.
Federated Learning’in Teknik Zorlukları
Federated Learning’i üretime almak, klasik bir modeli eğitmekten çok daha fazla mühendislik zorluğu barındırıyor. Üç ana zorluk kategorisi öne çıkıyor:
- İstatistiksel heterojenlik (non-IID veri): Her kullanıcının verisi farklı dağılıma sahip olabilir; biri çok yazan bir kullanıcı, diğeri neredeyse hiç veri üretmeyen bir kullanıcı olabilir. Bu dengesizlik, modelin bazı kullanıcı gruplarında diğerlerinden daha iyi çalışmasına yol açabilir.
- Sistem heterojenliği: Katılımcı cihazlar farklı işlemci gücüne, bellek kapasitesine ve ağ bağlantı kalitesine sahiptir. Zayıf bir cihaz eğitim turunu tamamlayamayıp süreci yavaşlatabilir; bu yüzden çoğu gerçek sistem, belirli bir süre içinde yanıt vermeyen cihazları turdan çıkarır.
- İletişim maliyeti: Model büyüdükçe (özellikle büyük dil modellerinde), her turda milyonlarca cihazla ağırlık alışverişi yapmak ciddi bir bant genişliği yükü oluşturur. Bu nedenle güncellemelerin sıkıştırılması (quantization, sparsification) federated learning sistemlerinde kritik bir optimizasyon alanı.
Bu üç zorluğun ortak noktası, hepsinin de sistemi tasarlarken “en zayıf halka” mantığıyla düşünmeyi gerektirmesi. Bir federated learning sistemi, en güçlü ve en aktif katılımcıya göre değil, ortalama ya da hatta en yavaş katılımcının gerçekçi koşullarına göre tasarlanmalı; aksi halde sistem teoride çalışıp pratikte büyük ölçekte kullanılamaz hale gelebilir. Bu yüzden çoğu üretim sistemi, belirli bir tur için tüm cihazları aynı anda beklemek yerine rastgele bir alt küme seçer ve yeterli sayıda cihaz yanıt verdiğinde turu tamamlayarak zaman kaybını sınırlandırır.
Federated Learning Kurulum Kontrol Listesi
Bir federated learning projesine başlamadan önce gözden geçirilmesi gereken temel maddeler:
- Verinin gerçekten merkezi olarak toplanamayacağı (yasal, etik veya rekabetçi) bir gerekçe var mı?
- Katılımcı cihazların/kurumların yeterli hesaplama gücüne ve ağ bağlantısına sahip olduğu doğrulandı mı?
- Model güncellemelerinin bilgi sızdırma riskine karşı differential privacy veya güvenli toplama (secure aggregation) uygulanacak mı?
- Kötü niyetli veya bozuk güncellemeleri filtreleyecek bir sağlamlaştırma (robust aggregation) mekanizması planlandı mı?
- Modelin performansı, yalnızca merkezi test setinde değil, katılımcı cihazların temsil ettiği çeşitlilikte de ölçülüyor mu?
Türkiye’de KVKK Açısından Neden Önemli?
Türkiye’de kişisel verilerin işlenmesini düzenleyen Kişisel Verilerin Korunması Kanunu (KVKK), özellikle sağlık verisi gibi özel nitelikli kişisel verilerin işlenmesinde sıkı kurallar öngörüyor. Bir hastane grubunun veya finans kuruluşunun, hastaların ya da müşterilerin ham verisini tek bir merkezi sunucuda birleştirmeden ortak bir yapay zeka modeli geliştirmek istemesi durumunda, federated learning teknik olarak “veriyi yerinde bırakma” ilkesine uygun bir mimari sunuyor. Bu, KVKK uyumluluğunu otomatik olarak garanti etmez -veri işleme envanteri, aydınlatma yükümlülüğü ve geçerli veri işleme şartı gibi gereklilikler ayrıca yerine getirilmelidir- ancak veri minimizasyonu ilkesini teknik mimariye yansıtmak isteyen kurumlar için değerlendirilmeye değer, somut bir mühendislik yaklaşımı oluşturuyor.
Gerçek Dünyadan Kullanım Alanları
Federated Learning artık akademik bir kavram olmaktan çıkıp gerçek ürünlerde kullanılıyor:
Google Gboard
Klavyenin bir sonraki kelime tahminini, kullanıcıların yazdığı gerçek metinleri Google’ın sunucularına göndermeden, doğrudan telefonlarda eğiterek geliştiriyor. Google’ın araştırma ekibi, bu sürece ek olarak “formal differential privacy” garantileri de ekleyerek, birleştirilen model güncellemelerinden bile tek bir kullanıcının yazdığı kelimelerin geri çıkarılamayacağını matematiksel olarak güvence altına almaya çalışıyor.
Apple’ın Cihaz Üstü Öğrenme Yaklaşımı
Apple, klavye önerileri ve bazı kişiselleştirme özelliklerinde kullanıcı verisini cihazda tutan benzer teknikleri kullandığını açıklıyor. Şirket, bu yaklaşımı genel gizlilik stratejisinin bir parçası olarak konumlandırıyor ve mümkün olduğunca fazla işlemi buluta göndermeden cihaz üzerinde tamamlamayı hedefliyor.
Sağlık Sektörü ve Çok Kurumlu Araştırmalar
NVIDIA Clara gibi platformlar, farklı hastanelerin hasta verilerini birbirleriyle veya merkezi bir sunucuyla paylaşmadan, ortak bir tanı modelini birlikte eğitmesine olanak tanıyor. Bu yaklaşım hem hasta mahremiyetini korumak hem de tek bir hastanenin veri setinin sınırlı kalması sorununu aşmak için tercih ediliyor; özellikle nadir görülen hastalıklarda tek bir hastanenin yeterli örnek sayısına ulaşması genellikle mümkün olmuyor, federated learning bu örnekleri veriyi taşımadan birleştirerek daha güçlü bir model eğitilmesine imkân tanıyor.
Finans Sektöründe Dolandırıcılık Tespiti
Birden fazla banka, müşteri işlem verisini birbirleriyle paylaşmadan, ortak bir dolandırıcılık tespit modelini federated learning ile eğitebiliyor. Her banka kendi işlem geçmişini yerinde tutarken, modelin tüm bankalardaki dolandırıcılık kalıplarından öğrenmesi mümkün oluyor; bu da tek bir bankanın verisiyle eğitilen modellere göre daha güçlü bir genel performans sağlayabiliyor.
Federated Learning ile Diğer Yaklaşımların Karşılaştırması
| Yaklaşım | Veri Nerede Durur | Gizlilik değerlendirmesi | Tipik Kullanım |
|---|---|---|---|
| Merkezi (Centralized) Eğitim | Merkezi sunucu / veri merkezi | Erişim ve koruma tasarımına bağlı | Büyük dil modelleri, genel amaçlı modeller |
| Federated Learning | Kullanıcı cihazı / kurum sunucusu | Güncelleme sızıntısı için ek önlem gerekir | Klavye tahmini, sağlık verisi, kişiselleştirme |
| On-Device AI (yalnızca çıkarım) | Model cihazda çalışır, eğitim merkezi | Yerel uygulama ve veri akışına bağlı | Kamera filtreleri, sesli asistan çıkarımı |
| Differential Privacy ile Merkezi Eğitim | Merkezi sunucu, veriye gürültü eklenir | DP bütçesi ve uygulama koşullarına bağlı | İstatistiksel analiz, anonimleştirilmiş raporlama |
Federated Learning Kurarken Sık Yapılan Hatalar
1. Cihazlar arası veri dengesizliğini göz ardı etmek
Gerçek dünyada her kullanıcının cihazındaki veri miktarı ve dağılımı birbirinden çok farklıdır (buna “non-IID veri” denir). Bu dengesizliği hesaba katmadan basit bir ortalama almak, modelin bazı kullanıcı gruplarında kötü performans göstermesine yol açabilir. Çözüm: FedAvg’ın zaten kullandığı örnek sayısı ağırlıklandırmasını ve gerekirse FedProx gibi dengesizliğe karşı daha dayanıklı algoritmaları değerlendirmek.
2. Güncellemelerin kendisinin de bilgi sızdırabileceğini unutmak
Ham veri cihazdan çıkmasa da, model güncellemelerinin kendisi bazı durumlarda geri mühendislikle hassas bilgi sızdırabilir; araştırmacılar, belirli koşullarda bir gradyan güncellemesinden orijinal eğitim örneğinin kısmen yeniden oluşturulabildiğini gösteren çalışmalar yayınladı. Çözüm: güncellemelere differential privacy (diferansiyel gizlilik) gibi ek gürültü ekleme teknikleri uygulamak ve mümkünse güvenli toplama (secure aggregation) protokolleriyle sunucunun tek bir cihazın güncellemesini asla tek başına görememesini sağlamak.
3. Ağ ve pil maliyetini hesaba katmamak
Mobil cihazlarda sık ve büyük model güncellemeleri göndermek, kullanıcının pilini ve veri paketini tüketir; bu da uygulamanın mağaza değerlendirmelerine olumsuz yansıyabilir. Çözüm: güncellemeleri sıkıştırmak, yalnızca cihaz şarj olurken, boştayken ve Wi-Fi’a bağlıyken eğitim turuna katılmasına izin vermek, böylece kullanıcı deneyimine etkisini azaltmak.
4. Kötü niyetli katılımcılara karşı savunmasız kalmak
Sisteme dahil olan bir cihaz, kasıtlı olarak bozuk veya zararlı güncellemeler gönderip modelin genel performansını düşürmeye ya da modele gizli bir “arka kapı” davranışı yerleştirmeye çalışabilir (buna “model zehirleme” veya “backdoor saldırısı” denir). Bu risk, özellikle katılımcı sayısının çok ve kimlik doğrulamanın zayıf olduğu açık sistemlerde artıyor. Çözüm: anormal güncellemeleri istatistiksel olarak tespit edip filtreleyen sağlamlaştırılmış (robust) birleştirme algoritmaları kullanmak ve katılımcı cihazları/kurumları güvenilir bir kimlik doğrulama sürecinden geçirmek.
5. Test ve doğrulamayı yalnızca merkezi veri setinde yapmak
Model merkezi bir test setinde iyi görünse de, gerçek cihazlardaki çeşitliliği yansıtmayabilir. Çözüm: modelin performansını, katılımcı cihazların bir alt kümesinde de düzenli olarak değerlendirmek.
Sık Sorulan Sorular
Federated Learning nedir, tek cümleyle nasıl özetlenir?
Federated Learning, ham verinin cihazdan hiç çıkmadığı, yalnızca model güncellemelerinin merkezi bir sunucuda birleştirildiği dağıtık bir yapay zeka eğitim yöntemidir.
Federated Learning tamamen gizlilik garantisi verir mi?
Hayır. Ham veri paylaşılmasa da model güncellemeleri bazı senaryolarda bilgi sızdırabilir; bu yüzden genellikle differential privacy gibi ek tekniklerle birlikte kullanılması önerilir.
Küçük bir şirket Federated Learning kullanabilir mi?
Evet, Flower gibi açık kaynaklı çerçeveler sayesinde büyük bir altyapı ekibi olmadan da küçük ölçekli federated learning deneyleri kurmak mümkün; ancak gerçek kullanıcı cihazlarında ölçekli bir sistem kurmak ayrı bir mühendislik çabası gerektirir.
Federated Learning ile normal bulut tabanlı eğitim arasında hangisi daha hızlı?
Genellikle merkezi eğitim daha hızlıdır çünkü tüm veri tek bir güçlü sunucuda işlenir; federated learning ise ağ gecikmesi ve cihaz çeşitliliği nedeniyle daha yavaş yakınsayabilir, ancak gizlilik avantajı bu maliyeti çoğu zaman dengeler.
Federated Learning hangi sektörlerde en çok tercih ediliyor?
Mobil klavye ve asistan uygulamaları, sağlık ve tıbbi görüntüleme, finans gibi verinin yasal veya etik nedenlerle merkezi bir sunucuda toplanamadığı sektörlerde yaygın olarak tercih ediliyor.
Federated Learning için hangi araçları öğrenmek gerekir?
Başlangıç için Flower (flwr) veya TensorFlow Federated gibi açık kaynaklı çerçeveleri, PyTorch veya TensorFlow gibi temel bir derin öğrenme kütüphanesiyle birlikte öğrenmek yeterli bir temel oluşturuyor; kurumsal ölçekte ise NVIDIA FLARE veya Intel OpenFL gibi platformlar daha kapsamlı özellikler sunuyor.
Sonuç: Bu Yöntem Kime, Hangi Durumda Uygun?
Federated Learning nedir sorusunun cevabı, aslında “verinizi merkezi bir yerde toplayamıyorsanız veya toplamak istemiyorsanız modelinizi nasıl eğitirsiniz?” sorusunun cevabıdır. Kullanıcı verisinin yasal, etik veya rekabetçi nedenlerle merkezi bir sunucuda birleştirilemediği durumlarda -örneğin farklı hastanelerin ortak bir tanı modeli eğitmesi ya da bir klavye uygulamasının kullanıcı metnini hiç görmeden öneri geliştirmesi gerektiğinde- federated learning gerçek bir çözüm sunuyor. Buna karşılık, verinizi zaten merkezi olarak toplayabiliyorsanız ve gizlilik kısıtlaması yoksa, klasik merkezi eğitim hem daha basit hem de genellikle daha hızlı bir yol olmaya devam ediyor. Karar, teknik tercihten çok, verinin nerede durabileceğine dair yasal ve etik bir sınırdan doğuyor.
Pratik bir özet olarak: bireysel bir geliştiriciyseniz ve tek bir uygulamanın kullanıcı verisiyle çalışıyorsanız, önce Flower gibi bir çerçeveyle küçük bir simülasyon kurup federated learning’in kendi probleminize gerçekten değer katıp katmadığını test etmek mantıklı bir ilk adım. Kurumsal bir ekipseniz ve birden fazla şubenin, hastanenin veya iş ortağının verisini birleştirmeniz gerekiyorsa, önce yasal ve idari gereklilikleri (KVKK kapsamındaki yükümlülükler dahil) netleştirip ardından teknik mimariyi buna göre tasarlamak, sonradan geri dönüp mimariyi değiştirmekten çok daha az maliyetli olacaktır.
Kaynaklar
Açık rıza her işlem için tek hukuki dayanak değildir; uygulanacak şart verinin türü ve işleme amacına göre ayrıca değerlendirilir.