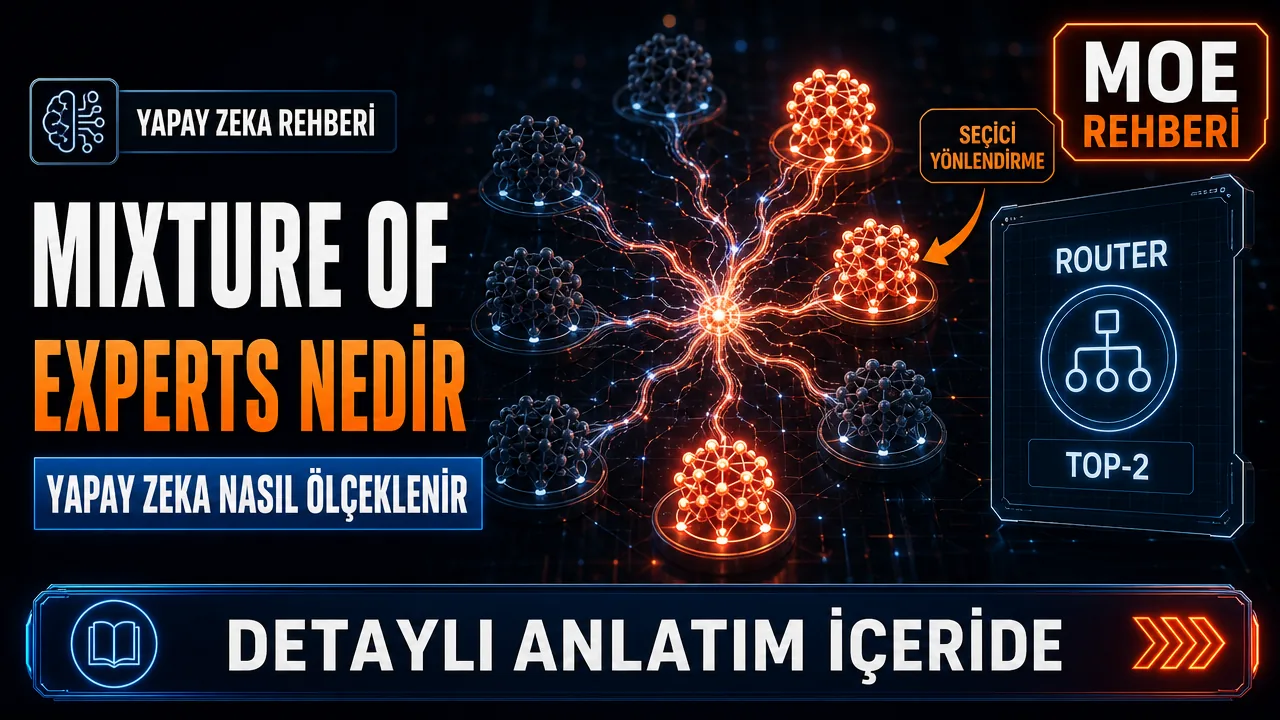
Mixture of Experts nedir? Mixture of Experts (kısaca MoE), bir yapay zeka modelinin tüm parametrelerini her girdi için aynı anda çalıştırmak yerine, o girdiye en uygun küçük “uzman” alt ağları seçerek çalıştırdığı bir sinir ağı mimarisi. 2023 sonrasında Mixtral, Grok, DeepSeek ve Llama 4 gibi büyük dil modellerinin neredeyse tamamı bu mimariyi benimsedi; çünkü MoE, model boyutunu (ve dolayısıyla bilgi kapasitesini) artırırken çalıştırma maliyetini dense (yoğun) modellere göre çok daha düşük tutmayı mümkün kılıyor. Bu yazıda MoE nedir, uzman karışımı modeli nasıl çalışır ve kendi projenizde nasıl değerlendirebilirsiniz, somut örnekler ve gerçek model verileriyle ele alıyoruz.
Mixture of Experts Nedir, Nasıl Çalışır?
Geleneksel “dense” (yoğun) bir dil modelinde, her token için modelin tüm parametreleri hesaplamaya dahil olur. Parametre sayısı arttıkça hem eğitim hem de çıkarım (inference) maliyeti doğrusal biçimde artar. Mixture of Experts mimarisi bu dengeyi değiştiriyor: model, her katmanda tek bir büyük ileri beslemeli (feed-forward) blok yerine, birden fazla küçük “uzman” bloktan oluşan bir grup barındırıyor. Her token işlenirken bu uzmanların tamamı değil, yalnızca birkaçı devreye giriyor.
Router (Gating) Mekanizması
Hangi uzmanların devreye gireceğine “router” veya “gating network” adı verilen küçük bir sinir ağı karar veriyor. Router, gelen her token için uzmanlara bir skor atıyor ve genellikle en yüksek skora sahip 1-2 uzmanı (top-1 veya top-2 routing) seçiyor. Örneğin sekiz uzmanlı bir katmanda top-2 routing kullanılıyorsa, her token yalnızca 2 uzman üzerinden işleniyor; diğer 6 uzman o token için hiç çalışmıyor.
Uzman (Expert) Katmanları
Her “uzman”, aslında standart bir ileri beslemeli sinir ağı katmanı. Modelin eğitimi sırasında uzmanlar belirli bir konuya veya dil türüne göre önceden programlanmış biçimde uzmanlaşmaz; bunun yerine eğitim verisi ve router’ın yönlendirmesiyle kendiliğinden farklı örüntülere duyarlı hâle gelirler. Araştırmalar, bazı uzmanların sözdizimsel örüntülere, bazılarının ise belirli kelime dağarcığı veya alanlara daha duyarlı hâle geldiğini gösteriyor; ancak bu uzmanlaşma insan tarafından tanımlanan net kategoriler şeklinde değil.
MoE’nin Kısa Tarihçesi
Mixture of Experts fikri aslında yapay zeka literatüründe oldukça eski; kavramın kökleri 1991 yılına, Robert Jacobs ve meslektaşlarının “adaptive mixtures of local experts” adlı çalışmasına kadar uzanıyor. Ancak fikrin büyük dil modellerinde pratik bir karşılık bulması 2017 yılında Google araştırmacılarının yayımladığı “Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer” makalesiyle oldu; bu çalışma, günümüzde kullanılan seyrek (sparse) MoE katmanlarının temelini attı. 2020’de GShard ve 2021’de Switch Transformer çalışmaları, MoE’yi trilyon parametre seviyesine taşıyarak mimarinin gerçekten büyük ölçekte çalışabileceğini gösterdi. Ancak MoE’nin geniş kitlelerce “ana akım” bir tercih olarak benimsenmesi, Mistral AI’ın Aralık 2023’te Mixtral 8x7B’yi açık ağırlıklarla yayımlamasıyla hızlandı; bu, güçlü bir MoE modelinin ilk kez geniş çaplı şekilde incelenebilir ve kendi donanımında çalıştırılabilir hâle gelmesini sağladı. 2024-2026 arasında xAI, DeepSeek, Meta ve Alibaba gibi şirketlerin kendi büyük MoE modellerini yayımlamasıyla mimari, büyük dil modeli tasarımında neredeyse varsayılan yaklaşım hâline geldi.
Neden Dense Modeller Yerine MoE Tercih Ediliyor?
MoE mimarisinin öne çıkmasının temel nedeni, “toplam parametre sayısı” ile “aktif parametre sayısı” arasındaki ayrımı mümkün kılması. Bir MoE modeli toplamda yüzlerce milyar parametre barındırabilir, ancak her token için bunların yalnızca küçük bir kısmı (örneğin %10-15’i) hesaplamaya dahil olur. Bu da modelin dense bir eşdeğerine göre çok daha fazla bilgi kapasitesine sahip olmasını, ancak çıkarım maliyetinin çok daha küçük bir dense modelle kıyaslanabilir seviyede kalmasını sağlıyor.
- Ölçekleme avantajı: Toplam parametre sayısı artırılarak model kapasitesi büyütülebilir, aktif parametre sayısı sabit tutularak çıkarım maliyeti kontrol altında kalır.
- Eğitim verimliliği: Aynı hesaplama bütçesiyle dense modele göre daha fazla parametre eğitilebilir.
- Uzmanlaşma potansiyeli: Farklı uzmanlar farklı görev türlerinde daha isabetli sonuçlar üretebilir.
Chinchilla Ölçekleme Yasasıyla İlişkisi
2022’de DeepMind’ın yayımladığı “Chinchilla” ölçekleme çalışması, sabit bir hesaplama bütçesinde model performansını en iyileştirmek için parametre sayısı ile eğitim verisi miktarının belirli bir oranda dengelenmesi gerektiğini ortaya koymuştu. MoE mimarisi bu denklemi ilginç biçimde genişletiyor: toplam parametre sayısını artırarak modelin “bilgi depolama” kapasitesini büyütürken, aktif parametre sayısını (ve dolayısıyla token başına hesaplama maliyetini) bağımsız olarak kontrol etmeyi mümkün kılıyor. Bu ayrım, araştırmacıların “aynı çıkarım bütçesiyle daha yetenekli bir model” ya da “aynı yetenek seviyesinde çok daha ucuz bir çıkarım” hedeflerinden hangisine öncelik vereceklerini seçebilmelerine olanak tanıyor.
MoE Mimarisinin Teknik Detayları
Top-k Routing ve Load Balancing
Uzmanların dengesiz seçilmesi yük ve eğitim sorunları yaratabilir. Bazı modeller yardımcı yük dengeleme kaybı kullanır. DeepSeek-V3’ün auxiliary-loss-free yaklaşımı ise yönlendirme kararlarına dinamik uzman yanlılıkları ekleyerek dengelemeyi hedefler; bunu “yardımcı kayıp terimi” olarak adlandırmak doğru değildir.
Hugging Face Transformers ile MoE Modeli Yükleme
Açık ağırlıklı bir MoE modelini yerel olarak yüklerken, model konfigürasyonunda uzman sayısı ve aktif uzman sayısı gibi parametreleri görebilirsiniz:
from transformers import AutoModelForCausalLM, AutoTokenizer

model_name = "mistralai/Mixtral-8x7B-v0.1"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    device_map="auto",
    torch_dtype="auto",
)

# Model konfigürasyonunda MoE'ye özgü alanlar:
print(model.config.num_local_experts)      # toplam uzman sayısı (örn. 8)
print(model.config.num_experts_per_tok)    # token başına aktif uzman sayısı (örn. 2)
Bu iki değer, bir MoE modelinin “ne kadar büyük göründüğü” ile “gerçekte ne kadar hesaplama tükettiği” arasındaki farkı doğrudan gösteriyor.
2026’da Hangi Büyük Modeller MoE Kullanıyor?
MoE mimarisi artık niş bir araştırma tekniği olmaktan çıkıp, sektördeki en büyük açık ve kapalı modellerin çoğunda temel tasarım tercihi hâline geldi. Aşağıdaki tablo, kamuya açıklanmış teknik raporlara dayanan birkaç bilinen örneği karşılaştırıyor:
| Model | Toplam parametre | Aktif parametre | Uzman sayısı |
|---|---|---|---|
| Mixtral 8x7B (Mistral AI) | ~46,7 milyar | ~12,9 milyar | 8 (top-2 routing) |
| Grok-1 (xAI) | 314 milyar | ~78,7 milyar (%25) | 8 (top-2 routing) |
| DeepSeek-V3 | 671 milyar | 37 milyar | 256 yönlendirilen + 1 paylaşılan uzman |
| Llama 4 Maverick (Meta) | 400 milyar | 17 milyar | 128 |
| Qwen3-235B-A22B (Alibaba) | 235 milyar | 22 milyar | 128 (8 aktif) |
Tablodaki değerler ilgili şirketlerin yayımladığı teknik raporlara ve model kartlarına dayanıyor; yeni sürümlerle bu sayılar değişebileceğinden bir model üzerinde karar verirken güncel model kartını kontrol etmeniz önerilir.
Kapalı Kaynak Modellerde MoE Kullanımı
Kapalı modellerin yayımlanmamış uzman sayısı ve parametre ayrıntıları kesin bilgi gibi sunulmamalıdır. Fiyat ve gecikmeden tek başına MoE mimarisi çıkarılamaz. Teknik rapor açıklanmıyorsa mimariyi bilinmiyor olarak bırakın.
MoE Modelini Kendi Projenizde Nasıl Çalıştırırsınız?
Açık ağırlıklı bir MoE modelini kendi sunucunuzda veya bulut ortamınızda çalıştırmak, dense bir modele göre biraz farklı kaynak planlaması gerektiriyor. Aşağıdaki adımlar genel bir yol haritası sunuyor:
- Toplam parametre sayısına göre bellek planlayın: Toplam ağırlık boyutunu hesaba katın; aktif uzman sayısı bellek ihtiyacını göstermez. Uzmanlar GPU’lara dağıtılabilir veya RAM/offloading kullanılabilir; bu seçenekler hız ve iletişim maliyeti getirir. Yani bellek ihtiyacı toplam parametre sayısına göre, hesaplama maliyeti ise aktif parametre sayısına göre belirlenir.
- Uygun bir çıkarım motoru seçin: vLLM, TensorRT-LLM ve llama.cpp gibi motorların güncel sürümleri MoE mimarisini destekliyor; motor seçerken MoE desteğinin sürüm notlarında açıkça belirtildiğinden emin olun.
- Nicemleme (quantization) uygulamayı değerlendirin: Büyük toplam parametre sayısı nedeniyle MoE modellerinde 4-bit veya 8-bit nicemleme, bellek ayak izini önemli ölçüde azaltabilir.
- Sunucu başlatma komutunu yapılandırın: Aşağıdaki örnek, vLLM ile bir MoE modelinin nasıl servis edilebileceğini gösteriyor.
- Uç noktayı (endpoint) test edin: Modeli canlıya almadan önce farklı token uzunluklarında gecikme (latency) ve verim (throughput) testleri yapın.
# vLLM ile Mixtral 8x7B modelini API olarak servise açma örneği
vllm serve mistralai/Mixtral-8x7B-Instruct-v0.1 \
  --tensor-parallel-size 2 \
  --max-model-len 32768 \
  --gpu-memory-utilization 0.90 \
  --port 8000
--tensor-parallel-size 2, tensör paralelliği için iki GPU belirtir; uzman paralelliğini otomatik olarak ifade etmez. vLLM’de uzmanları ayrı GPU’lara yerleştirmek için desteklenen kurulumda --enable-expert-parallel ve ilgili veri/tensör paralellik ayarları değerlendirilir. Donanım ihtiyacını toplam ağırlıklar ve KV cache ile hesaplayın.
MoE’nin Pratikte Kullanım Alanları
MoE mimarisinin sağladığı verimlilik avantajı, özellikle şu senaryolarda pratik bir fark yaratıyor:
- Yüksek hacimli sohbet asistanları: Milyonlarca kullanıcıya aynı anda hizmet veren API servislerinde, token başına düşük aktif parametre sayısı doğrudan sunucu maliyetine yansıyor.
- Çok dilli modeller: Bazı uzmanların belirli dil ailelerine veya yazım sistemlerine daha duyarlı hâle gelmesi, çok dilli performansı dense modellere göre nispeten daha verimli biçimde artırabiliyor.
- Kod üretimi ve teknik görevler: Farklı programlama dilleri veya görev türleri için farklı uzmanların devreye girmesi, karma görev setlerinde tutarlılığı destekleyebiliyor.
- Araştırma ve deneysel ölçekleme: Araştırma laboratuvarları, aktif parametre sayısını sabit tutarak toplam parametre sayısını (ve dolayısıyla model kapasitesini) daha düşük ek maliyetle deneyebiliyor.
MoE Modellerini İnce Ayar Yaparken Nelere Dikkat Etmeli?
Bir MoE modelini kendi veri setinizle ince ayar (fine-tuning) yapmayı planlıyorsanız, dense modellerden farklı birkaç noktaya dikkat etmeniz gerekiyor:
- Router’ı dondurmayı değerlendirin: Küçük veri setleriyle yapılan ince ayarlarda router ağırlıklarını sabit tutmak, yük dengesinin bozulmasını önleyebilir.
- Uzman kullanım istatistiklerini izleyin: Eğitim sırasında hangi uzmanların ne sıklıkla seçildiğini loglayarak aşırı yüklenen veya neredeyse hiç kullanılmayan uzmanları tespit edin.
- Öğrenme oranını (learning rate) uzmanlar için ayrı ayarlamayı düşünün: Bazı ince ayar çerçeveleri, router ve uzman katmanları için farklı öğrenme oranları tanımlamaya izin veriyor.
- Değerlendirmeyi görev bazında yapın: Genel bir doğruluk metriği, belirli uzmanlardaki gerilemeyi gizleyebilir; görev türüne göre ayrı değerlendirme yapmak sorunları daha erken yakalamanıza yardımcı olur.
MoE’nin Dezavantajları ve Sınırları
MoE mimarisi çıkarım maliyetini düşürse de bedelsiz değil. Öncelikle, toplam uzman ağırlıklarının saklanması gerektiğinden toplam bellek ihtiyacı dense bir modele göre daha yüksek kalabiliyor; bu da MoE modellerini küçük GPU’larda veya tüketici donanımında çalıştırmayı zorlaştırıyor. İkinci olarak, uzmanlar arasında dengesiz yük dağılımı, eğitim sırasında bazı uzmanların yetersiz eğitilmesine yol açabiliyor. Üçüncü olarak, ince ayar (fine-tuning) süreçleri dense modellere göre daha karmaşık; hangi uzmanların hangi veriyle güncelleneceğinin doğru yönetilmesi gerekiyor. Son olarak, dağıtık sunucu ortamlarında uzmanlar arası iletişim (all-to-all communication) ek bir gecikme kaynağı olabiliyor: farklı uzmanlar farklı GPU’larda barındırıldığında, bir token’ın işlenmesi için ilgili GPU’lar arasında sürekli veri alışverişi gerekiyor. Bu iletişim yükü, özellikle ağ bant genişliğinin sınırlı olduğu kümelerde, teorik hesaplama tasarrufunun bir kısmını geri alabiliyor. Bu nedenle üretim ortamında MoE modeli çalıştıran ekipler, genellikle yüksek bant genişlikli GPU-arası bağlantılara (NVLink, InfiniBand gibi) yatırım yapmak durumunda kalıyor.
MoE ile Dense Model: Hızlı Karşılaştırma
| Kriter | Dense Model | Mixture of Experts |
|---|---|---|
| Hesaplama (token başına) | Tüm parametreler aktif | Yalnızca seçilen uzmanlar aktif |
| Bellek ihtiyacı | Parametre sayısıyla orantılı | Toplam parametre sayısına göre (genelde daha yüksek) |
| Eğitim karmaşıklığı | Görece basit | Load balancing, routing kararlılığı gerektirir |
| Donanım uygunluğu | Tek GPU / küçük kümeler | Çok GPU’lu, yüksek bellekli kümeler |
| Tipik kullanım alanı | Kenar cihazlar, küçük servisler | Büyük ölçekli API servisleri |
Bu tablo, iki yaklaşımın birbirinin yerine geçen değil, farklı kısıtlar altında farklı avantajlar sunan tamamlayıcı seçenekler olduğunu gösteriyor. Karar verirken model kalitesinden çok, elinizdeki donanım bütçesi ve beklenen trafik hacmi genellikle belirleyici faktör oluyor.
Sık Yapılan Hatalar
- Toplam parametre sayısına bakıp donanım ihtiyacını hafife almak: “37 milyar aktif parametre” ifadesini görüp modelin küçük bir GPU’ya sığacağını düşünmek yaygın bir hata; toplam parametre sayısı bellek planlamasında belirleyicidir.
- MoE desteklemeyen eski bir çıkarım motoru kullanmak: Bazı eski sürümler MoE katmanlarını dense gibi işleyerek performans kaybına veya hatalara yol açabilir.
- Load balancing ayarlarını göz ardı ederek ince ayar yapmak: Yük dengeleme kaybı olmadan yapılan fine-tuning, bazı uzmanların tamamen devre dışı kalmasına neden olabilir.
- Çıkarım sırasında top-k değerini serbest ayar sanmak: Router, belirli seçim düzeniyle eğitilir. Uzman sayısını değiştirmek kaliteyi bozabilir; resmî yapılandırmayı ve desteklenen çıkarım seçeneklerini izleyin.
- Nicemleme sonrası doğruluk kaybını test etmemek: MoE modellerinde agresif nicemleme, router kararlarının hassasiyetini bozarak beklenmedik kalite düşüşlerine yol açabilir; nicemleme sonrası mutlaka çıktı kalitesi karşılaştırması yapılmalı.
MoE mi Dense mi? Kime, Hangi Durumda Uygun?
Yeterli VRAM/bellek kapasitesine sahip, yüksek model kalitesini düşük çıkarım maliyetiyle birleştirmek isteyen ekipler için MoE mimarisi genellikle avantajlı bir tercih. Özellikle büyük ölçekli API servisleri işleten ve token başına maliyeti düşürmeyi önceliklendiren şirketler için MoE modelleri cazip bir denge sunuyor. Buna karşın, sınırlı belleğe sahip donanımlarda (tek GPU’lu geliştirme ortamları, kenar (edge) cihazlar) çalışacak uygulamalarda, toplam bellek ayak izi daha küçük olan dense veya küçük dil modelleri (SLM) genellikle daha pratik bir seçim oluyor. Bu konudaki ayrımı daha ayrıntılı görmek isteyenler Küçük Dil Modeli Nedir? SLM Büyük Modelden Farkı (2026) ve Quantization Nedir? Yapay Zeka Modeli Nasıl Küçültülür? yazılarımıza göz atabilir; çıkarım ve eğitim maliyetleri arasındaki farkı merak edenler için ise Yapay Zeka Çıkarımı Nedir? Eğitim ile Farkı ve Maliyeti yazımız tamamlayıcı bilgi sunuyor.
Özetle: MoE Hakkında Akılda Kalması Gerekenler
Mixture of Experts, “daha büyük model = daha pahalı çıkarım” denklemini kıran bir mimari yaklaşım olarak 2023 sonrasında hızla yaygınlaştı. Router mekanizması sayesinde her token yalnızca birkaç uzman üzerinden işleniyor, bu da toplam parametre sayısı çok yüksek olsa bile token başına hesaplama maliyetini makul seviyede tutuyor. Bununla birlikte MoE, bedelsiz bir sihirli çözüm değil: yüksek bellek ihtiyacı, karmaşık yük dengeleme gereksinimi ve dağıtık ortamlarda iletişim yükü gibi gerçek mühendislik zorlukları beraberinde getiriyor. Bir projede MoE kullanıp kullanmama kararı, nihayetinde elinizdeki donanım bütçesi, beklenen trafik hacmi ve ekibinizin dağıtık sistem yönetimi konusundaki deneyimiyle şekillenmeli.
Sık Sorulan Sorular
Mixture of Experts nedir, kısaca?
Mixture of Experts, bir modelin tüm parametrelerini değil, her girdi için router’ın seçtiği küçük bir uzman alt kümesini çalıştırdığı sinir ağı mimarisidir.
MoE modelleri neden dense modellerden daha ucuz çalışıyor?
Çünkü her token için modelin yalnızca aktif uzmanlara denk gelen küçük bir kısmı hesaplamaya dahil oluyor; toplam parametre sayısı yüksek olsa da işlem yükü çok daha düşük kalıyor.
MoE modelleri her donanımda çalışır mı?
Hayır; toplam ağırlıklar saklanıp gerektiğinde erişilmek zorunda olduğundan, toplam parametre sayısı yüksek MoE modelleri sınırlı VRAM’e sahip donanımlarda çalıştırmak için zorlayıcı olabilir.
Top-1 ve top-2 routing arasındaki fark nedir?
Top-1 routing her token için tek bir uzman seçerken, top-2 routing iki uzmanı birlikte devreye sokar; top-2 genellikle biraz daha yüksek kalite sunar ama biraz daha fazla hesaplama gerektirir.
Hangi büyük dil modelleri MoE mimarisi kullanıyor?
Mixtral, Grok-1, DeepSeek-V3, Llama 4 Maverick/Scout ve Qwen3’ün büyük varyantları gibi pek çok güncel model MoE mimarisini kullanıyor.
Teknik Kaynaklar