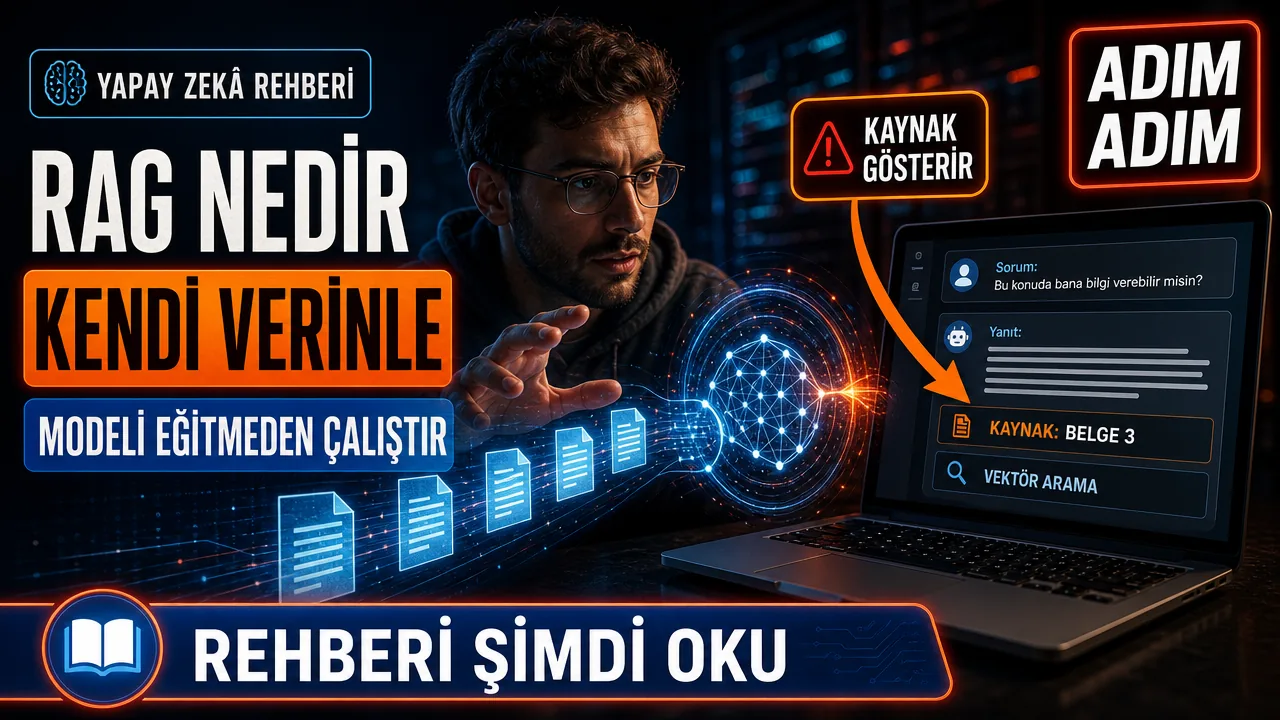
RAG nedir? RAG (Retrieval-Augmented Generation / Erişimle Zenginleştirilmiş Üretim), bir dil modelinin yanıt üretmeden önce harici bir bilgi kaynağından ilgili belgeleri çekip bunları yanıtına dayanak yapmasını sağlayan yöntemdir. Amaç, modelin yalnızca eğitim verisindeki bilgiyle sınırlı kalmasını önlemek ve cevapları doğrulanabilir kaynaklara bağlamaktır. Bu sayede şirket içi dokümanlar, ürün kataloğu veya güncel mevzuat gibi modelin eğitiminde bulunmayan bilgiler üzerinden cevap üretilebilir.
RAG Neden Ortaya Çıktı?
Büyük dil modellerinin iki temel kısıtı var. Birincisi, bilgileri eğitim verisinin kesim tarihinde donuyor; sonraki olayları ağırlıklarından bilemeyebilirler; prompt veya araçlardan yeni bağlam alabilirler. İkincisi, bilmedikleri bir konuda emin bir tonla yanlış cevap üretebiliyorlar — buna halüsinasyon deniyor.
Bu iki soruna karşı ilk akla gelen çözüm, modeli kendi verinizle yeniden eğitmek (fine-tuning). Ancak bu yaklaşım pahalı, yavaş ve her veri güncellemesinde tekrarlanması gerekiyor. RAG ise modeli hiç değiştirmeden, soru sorulduğu anda ilgili belgeleri bulup modele bağlam olarak veriyor. Veri değiştiğinde modeli değil yalnızca belge havuzunu güncellemeniz yeterli oluyor.
RAG Nasıl Çalışır? Adım Adım
Süreç iki ana aşamaya ayrılır: hazırlık (indeksleme) ve sorgu anı.
Hazırlık Aşaması
- Belge toplama: PDF, Word, web sayfası, veritabanı kaydı gibi kaynaklar bir araya getirilir.
- Parçalama (chunking): Belgeler anlamlı parçalara bölünür. Genelde 200-800 kelimelik bloklar tercih edilir; çok küçük parçalar bağlamı kaybettirir, çok büyük parçalar alakasız metin taşır.
- Vektöre çevirme (embedding): Her parça, anlamını temsil eden sayısal bir vektöre dönüştürülür.
- Depolama: Vektörler, benzerlik aramasına uygun bir vektör veritabanında saklanır.
Sorgu Anı
- Kullanıcının sorusu da aynı yöntemle vektöre çevrilir.
- Vektör veritabanında soruya anlamca en yakın parçalar bulunur (genelde ilk 3-10 parça).
- Bulunan parçalar, kullanıcının sorusuyla birlikte modele gönderilir.
- Model, cevabını bu parçalara dayanarak üretir ve ideal senaryoda kaynak referansı verir.
Kritik nokta şu: model burada “bilgiyi hatırlamıyor”, önüne konan metni okuyup özetliyor. Bu ayrım, RAG’ın neden halüsinasyonu azalttığını açıklıyor — ama tamamen ortadan kaldırmadığını da anlamamızı sağlıyor.
RAG ve Fine-Tuning Karşılaştırması
| Kriter | RAG | Fine-Tuning |
|---|---|---|
| Güncel bilgi | İndeks, izin ve cache güncellenince erişilebilir | Yeniden eğitim gerekir |
| Kurulum maliyeti | Orta (vektör veritabanı + hat) | Yüksek (GPU, veri etiketleme) |
| Kaynak gösterme | Doğal olarak mümkün | Zor |
| Üslup/format öğretme | Sınırlı | Güçlü |
| Sorgu başına maliyet | Daha yüksek (uzun bağlam) | Model, bağlam ve servis maliyetine bağlı |
| Veri gizliliği kontrolü | Belge düzeyinde yetkilendirme mümkün | Ağırlıklardan seçici silme zordur; yeni model/eğitim gerekebilir |
Pratikte bu ikisi rakip değil, tamamlayıcıdır. Yaygın yaklaşım şudur: bilgi RAG ile sağlanır, üslup ve çıktı formatı gerekirse fine-tuning veya iyi hazırlanmış bir sistem prompt’u ile ayarlanır.
RAG Halüsinasyonu Tamamen Bitirir mi?
Hayır. RAG halüsinasyon riskini azaltır ancak sıfırlamaz. Başlıca hata kaynakları şunlardır:
- Yanlış getirme: Arama, soruyla alakasız parçalar getirirse model yanlış bilgiye dayanarak cevap verir.
- Eksik getirme: Doğru cevap belge havuzunda var ama arama onu bulamazsa, model boşluğu kendi tahminiyle doldurabilir.
- Bağlamı aşma: Getirilen metin çok uzun olduğunda model önemli kısmı gözden kaçırabilir.
- Çelişkili kaynaklar: Havuzda birbiriyle çelişen iki belge varsa model hangisinin güncel olduğunu bilemez.
Bu nedenle ciddi kullanım senaryolarında modelin cevabıyla birlikte kaynak parçaları da göstermek, kullanıcının doğrulama yapabilmesi açısından önemlidir. Kaynak gösteren arama motorlarının bu yaklaşımı nasıl uyguladığını Perplexity incelememizde ele almıştık.
RAG Kalitesini Artıran Uygulamalar
- Parça boyutunu test edin: Tek bir “doğru” değer yok. Kendi belgelerinizle 300, 500 ve 800 kelimelik parçaları karşılaştırın.
- Örtüşme (overlap) bırakın: Ardışık parçalar arasında %10-20 örtüşme, cümlenin ortasından bölünen bağlamları kurtarır.
- Hibrit arama kullanın: Yalnızca anlamsal (vektör) arama yerine, anahtar kelime aramasıyla birleştirmek özel isim ve kod içeren sorgularda belirgin fark yaratır.
- Yeniden sıralama (reranking) ekleyin: İlk aramada 20-30 parça getirip bunları küçük bir sıralama modeliyle eleyip ilk 5’i modele vermek, doğruluğu artırma eğilimindedir.
- Meta veri filtreleyin: Tarih, departman, dil gibi alanlarla aramayı daraltmak, alakasız sonuçları baştan eler.
- Değerlendirme seti kurun: 30-50 gerçek soru ve beklenen cevaptan oluşan küçük bir test seti, yaptığınız her değişikliğin işe yarayıp yaramadığını ölçmenizi sağlar.
RAG Nerelerde İyi Çalışır, Nerelerde Zorlanır?
Yöntemin güçlü olduğu senaryolar genelde “cevap bir yerde yazılı ama bulması zor” durumlar: şirket içi bilgi tabanları, ürün dokümantasyonu, müşteri destek arşivleri, mevzuat metinleri ve teknik kılavuzlar. Bu tür kaynaklarda soru ile cevap arasında doğrudan bir metin eşleşmesi bulunur.
Zorlandığı yerler ise farklı bir yapıya sahip. Cevabın çok sayıda belgeyi birleştirip hesap yapmayı gerektirdiği sorular (“geçen yıl toplam kaç sipariş iptal edildi” gibi) RAG için uygun değil; bunlar yetkili SQL/hesaplama aracıyla çözülmeli; yapılandırılmış retrieval geniş hattın parçası olabilir. Benzer şekilde “en iyi hangisi” tipindeki öznel sorularda model, getirdiği belgelerin tonuna göre değişken cevaplar verebilir. Belgeler arasında zamansal çelişki varsa — örneğin eski ve yeni fiyat listesi bir arada duruyorsa — modelin hangisinin geçerli olduğunu ayırt etmesi zorlaşır; bu durumda meta veriyle tarih filtresi uygulamak pratik bir çözüm.
Güvenlik ve Gizlilik Notları
RAG kurarken sık atlanan bir konu yetkilendirme. Belge havuzuna erişimi olan herkes, teoride o havuzdaki her belgeye dayalı cevap alabilir. Bu nedenle arama katmanına kullanıcı bazlı erişim filtresi eklenmesi, yalnızca kullanıcının görmeye yetkili olduğu belgelerin getirilmesini sağlar.
İkinci konu, verinin nereye gittiği. Bulut tabanlı bir model kullanıyorsanız getirilen belge parçaları da sağlayıcıya gönderilir. Hassas veriyle çalışan ekipler için bu, sözleşme ve mevzuat açısından değerlendirilmesi gereken bir nokta. Bulut yapay zekâda verinin nerede işlendiğini ayrı bir yazıda ayrıntılandırmıştık.
Üçüncü olarak, dolaylı prompt enjeksiyonu riski var: belge havuzuna dışarıdan içerik alınıyorsa (örneğin web sayfaları), bu içeriğin içine gömülmüş talimatlar modeli yönlendirmeye çalışabilir. Dış kaynaklı içeriği veri olarak işaretlemek ve model çıktısını yetkili bir işlem tetikleyecek şekilde doğrudan kullanmamak, bu riski azaltan yaklaşımlardır.
Sonuç
RAG, dil modellerini kendi verinizle çalıştırmanın en pratik ve en hızlı geri dönüş veren yollarından biri. Modeli yeniden eğitmeden güncel bilgi sunması, kaynak gösterebilmesi ve veri güncellemesini kolaylaştırması temel avantajları. Buna karşılık kurulumun kalitesi doğrudan cevap kalitesini belirliyor: parçalama, arama ve sıralama adımları özensiz yapıldığında sonuç, modelin kendi başına verdiği cevaptan daha iyi olmayabilir. Küçük bir değerlendirme setiyle başlamak, bu adımları ölçerek iyileştirmenin en sağlıklı yolu.
Sık Sorulan Sorular
RAG nedir sorusunun en kısa cevabı nedir?
Dil modelinin, cevabı üretmeden önce sizin belgelerinizden ilgili parçaları bulup okuması ve cevabını bu parçalara dayandırmasıdır. Model yeniden eğitilmez; yalnızca soru anında doğru bağlam önüne konur.
RAG kurmak için makine öğrenmesi bilmem gerekiyor mu?
Temel bir RAG hattı kurmak için model eğitimi bilgisi gerekmiyor. Bir vektör veritabanı, bir embedding modeli ve bir dil modeli API’si ile çalışan örnekler mevcut. Ancak kaliteyi artırma aşamasında arama ve değerlendirme konularında biraz derinleşmek gerekiyor.
Küçük bir belge setim var, RAG’a gerek var mı?
Belgeleriniz modelin bağlam penceresine sığacak kadar azsa (örneğin birkaç sayfa), hepsini doğrudan prompt’a koymak daha basit ve genelde daha doğru sonuç verir. RAG, belge sayısı bağlam penceresine sığmayacak kadar arttığında anlamlı hâle gelir.
Hangi vektör veritabanını seçmeliyim?
Seçim ölçeğe ve altyapınıza bağlı. Az sayıda belge için mevcut veritabanınızın vektör eklentisi yeterli olabilir. Milyonlarca parça söz konusuysa özel amaçlı çözümler devreye girer. Başlangıçta en basit seçenekle başlayıp ihtiyaç doğdukça büyütmek genelde daha verimli bir yol.
RAG maliyetini nasıl düşürebilirim?
Modele gönderilen parça sayısını azaltmak, yeniden sıralama ile daha az ama daha isabetli parça göndermek ve sık sorulan sorular için önbellek kullanmak başlıca yöntemler. Belge embedding’i güncellemeyle yenilenir; sorgu embedding’i ve arama da tekrarlayan maliyettir. Model gideriyle birlikte ölçün.
RAG ile ajan mimarisi arasındaki fark nedir?
RAG bir bilgi getirme yöntemidir; ajan ise çok adımlı görevleri planlayıp araç çağıran bir yapıdır. Bir ajan, araçlarından biri olarak RAG’ı kullanabilir. İkisi rakip değil, farklı katmanlardır. Otonom yapay zekâ ajanlarının nasıl çalıştığını ayrı bir rehberde anlatmıştık.
Bu yazı, AI API Entegrasyonu Rehberi başlıklı merkez rehberin bir parçası. Entegrasyonun hangi adımında olduğunuzu ve sırada ne geldiğini oradan takip edebilirsiniz.
Kaynaklar ve İleri Okuma
Resmî dokümantasyon
Sitedeki ilgili rehberler
- AI Moderation Sistemi Nasıl Kurulur?
- Speech to Text API ile Ses Metne Nasıl Çevrilir?
- Streaming API ile Gerçek Zamanlı Yapay Zeka Yanıtı Alma
Hangi Sorunu Çözüyorsunuz?
Güncel bilgiyi retrieval, tekrarlanan görev davranışını gerekirse fine-tuning ile sağlayın. Basit prompt yeterliyse eğitim gerekmez. Yukarıdaki vektör akışı bir örnektir; BM25 veya SQL de mümkündür. Maliyeti aynı kalite ve trafikte ölçün. Belge silinince indeks ve cevap cache’ini de temizleyin.