RAG nedir? RAG (Retrieval Augmented Generation, Türkçe karşılığıyla erişim destekli üretim), bir büyük dil modelinin cevap üretmeden önce harici bir bilgi kaynağından ilgili belgeleri aramasını ve bu belgeleri istemine (prompt) ekleyerek daha güncel, doğru ve kaynağa dayalı yanıtlar vermesini sağlayan bir mimaridir. Klasik bir dil modeli yalnızca eğitim verisinde öğrendiklerine dayanarak cevap üretirken, RAG mimarisi modele “önce ara, sonra yanıtla” mantığıyla çalışan ek bir katman kazandırır.
Bu yaklaşım özellikle 2023 sonrasında kurumsal yapay zeka projelerinde yaygınlaşmış, 2026 itibarıyla da müşteri destek botlarından iç doküman arama sistemlerine kadar birçok üründe standart bir bileşen haline gelmiştir. RAG’ın popülerliğinin temel nedeni, modeli yeniden eğitmeden (fine-tuning yapmadan) güncel veya özel veriyle çalıştırabilmesidir.
RAG Nasıl Çalışır?
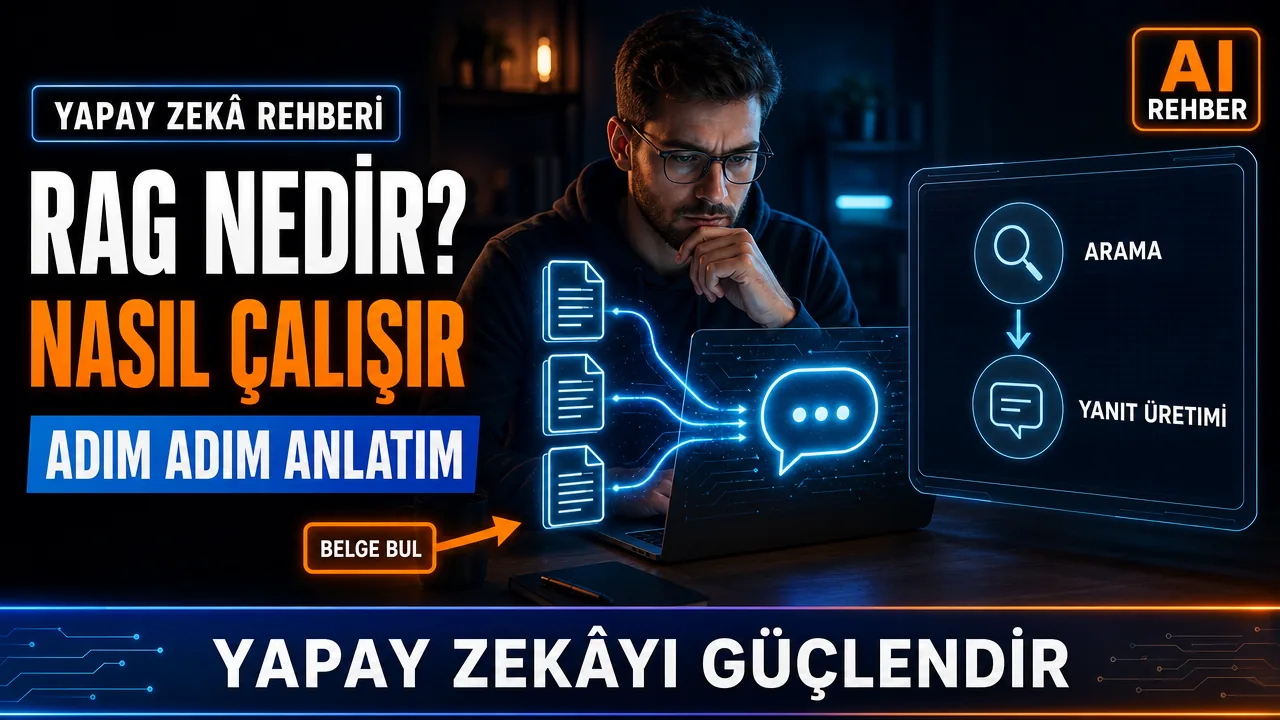
RAG mimarisi temelde üç adımdan oluşur: erişim (retrieval), zenginleştirme (augmentation) ve üretim (generation). Bir kullanıcı soru sorduğunda sistem önce bu soruyu bir vektör veritabanında arar, ardından bulunan en alakalı belge parçalarını modelin istemine ekler ve son olarak model bu bağlamı kullanarak yanıtı üretir.
- Belgeleri parçalara ayırma (chunking): Kaynak dokümanlar, aranabilir küçük metin parçalarına bölünür.
- Vektörleştirme (embedding): Her metin parçası, anlamsal benzerliği ifade eden sayısal bir vektöre dönüştürülür.
- Depolama: Bu vektörler bir vektör veritabanında (Pinecone, Weaviate, pgvector gibi) saklanır.
- Erişim: Kullanıcı sorusu da vektörleştirilir ve veritabanında en yakın anlamlı parçalar bulunur.
- Üretim: Bulunan parçalar, kullanıcı sorusuyla birlikte dil modeline gönderilir ve model bu bağlama dayalı bir yanıt üretir.
RAG Nedir Sorusuna Basit Bir Benzetme
RAG’ı, sınavda kitap açma iznine sahip bir öğrenciye benzetmek mümkün. Model, ezberlediği bilgilere (eğitim verisine) ek olarak, cevap vermeden önce ilgili sayfayı (kaynak belgeyi) açıp okuyabiliyor. Bu sayede hem daha güncel bilgiye erişebiliyor hem de yanıtını somut bir kaynağa dayandırabiliyor.
RAG ile Fine-Tuning Arasındaki Fark
RAG nedir sorusuna verilen yanıtı tam anlamak için, sık karıştırılan fine-tuning yöntemiyle farkını da netleştirmek gerekir. Fine-tuning, modelin ağırlıklarını yeni bir veri setiyle yeniden eğiterek kalıcı olarak değiştirmeyi ifade eder. RAG ise modelin ağırlıklarına dokunmadan, çalışma zamanında dışarıdan bilgi ekler.
| Özellik | RAG | Fine-Tuning |
|---|---|---|
| Veri güncelleme hızı | İndeksleme ve önbellek yenilenmesine bağlı | Yeniden eğitim gerekir |
| Maliyet | Görece düşük | Görece yüksek (eğitim maliyeti) |
| Kaynak gösterme | Mümkün (hangi belgeden geldiği izlenebilir) | Genellikle mümkün değil |
| Modelin davranışını değiştirme | Sınırlı | Daha güçlü |
Pratikte birçok kurumsal proje, iki yöntemi birlikte kullanır: modelin genel üslubu ve görev davranışı fine-tuning ile ayarlanırken, güncel ve değişken bilgi RAG üzerinden sağlanır.
RAG Nerelerde Kullanılır?
- Şirket içi doküman ve politika arama asistanları
- Müşteri destek chatbotları (güncel ürün bilgisiyle yanıt verme)
- Hukuki ve teknik doküman özetleme araçları
- Kod tabanı üzerinde soru-cevap yapan geliştirici asistanları
- Haber veya araştırma özetleme sistemleri
Bu sitede daha önce ele aldığımız MCP (Model Context Protocol) gibi standartlar, RAG sistemlerinin farklı veri kaynaklarına daha düzenli biçimde bağlanmasını kolaylaştıran tamamlayıcı bir katman olarak düşünülebilir.
Basit Bir RAG Kurulumu İçin Kontrol Listesi
Kendi RAG sisteminizi kurmayı planlıyorsanız, aşağıdaki adımları sırasıyla değerlendirmek işinizi kolaylaştırır:
- Kaynak dokümanlarınızı belirleyin ve hangi formatta olduklarını (PDF, HTML, veritabanı kaydı) tespit edin.
- Chunking stratejinizi belirleyin; çok küçük parçalar bağlamı kaybettirebilir, çok büyük parçalar alaka düzeyini düşürebilir.
- Bir embedding modeli ve vektör veritabanı seçin; ölçeğinize göre pgvector gibi hafif çözümler veya Pinecone gibi yönetilen servisler tercih edilebilir.
- Erişim (retrieval) adımında kaç belge parçasının modele gönderileceğini test ederek belirleyin.
- AI API entegrasyonu yaparken token limitlerini ve maliyetini göz önünde bulundurun; çok fazla bağlam göndermek maliyeti artırır.
- Modelin yanıtlarını kaynak belgeyle karşılaştırarak halüsinasyon (uydurma bilgi) oranını düzenli test edin.
Yaygın Hatalar
RAG sistemlerinde en sık karşılaşılan sorunlardan biri, alakasız belge parçalarının modele gönderilmesi ve bunun yanıt kalitesini düşürmesidir. Bir diğer yaygın hata, chunking sırasında bağlamın bölünüp anlamın kaybolmasıdır. Bu sorunların çözümü genellikle örtüşen (overlapping) parçalama stratejisi ve erişim sonuçlarının yeniden sıralanması (reranking) ile mümkün olur.
RAG mimarisi, dil modellerini statik bir bilgi deposu olmaktan çıkarıp canlı ve doğrulanabilir bir bilgi kaynağına bağlayan pratik bir çözüm sunuyor. Teknolojinin olgunlaşmasıyla birlikte, hem açık kaynak araçların hem de yönetilen servislerin sayısı hızla artıyor; bu da RAG’ı küçük ekipler için de erişilebilir kılıyor. Konunun akademik kökenine meraklı olanlar Retrieval-Augmented Generation’ın Wikipedia sayfasına göz atabilir.
RAG Sistemlerinde Maliyet Nasıl Yönetilir?
RAG mimarisinin görece düşük maliyetli olması, sınırsız bağlam göndermenin ücretsiz olduğu anlamına gelmiyor. Her erişim adımında modele gönderilen belge parçası sayısı arttıkça, işlenen token miktarı ve dolayısıyla API maliyeti de yükseliyor. Bu nedenle üretim ortamındaki bir RAG sisteminde, erişim adımının “en alakalı” parçaları getirmesi kadar “gereksiz yere fazla” parça getirmemesi de önemli bir optimizasyon hedefi.
Pratikte bu dengeyi kurmanın birkaç yolu var: erişilen belge sayısını (top-k) küçük tutup yeniden sıralama (reranking) ile kaliteyi artırmak, sık sorulan sorular için önbellekleme yapmak ve düşük öncelikli sorgularda daha küçük/ucuz bir modele yönlendirme yapmak. Bu optimizasyonlar, özellikle günde binlerce sorgu işleyen sistemlerde toplam maliyeti belirgin şekilde etkileyebilir.
RAG Sistemi Kurarken Hangi Veri Türleri Uygun?
RAG, yapılandırılmamış metin verisiyle en iyi sonucu verse de, tablo, kod veya yarı yapılandırılmış veri kaynaklarıyla da çalışabiliyor. Önemli olan, kaynak verinin aranabilir ve parçalanabilir bir formata dönüştürülebilmesi. Örneğin bir PDF kılavuzu, bir API dokümantasyonu, bir destek talebi arşivi veya bir iç wiki sayfası, hepsi RAG için uygun kaynak türleri arasında sayılabilir.
- Statik dokümanlar: Kılavuzlar, politikalar, SSS sayfaları
- Yarı dinamik veri: Ürün katalogları, fiyat listeleri (düzenli güncellenmesi gereken)
- Kod ve teknik dokümantasyon: API referansları, değişiklik günlükleri
- Konuşma geçmişi: Önceki destek talepleri, sık sorulan soru kayıtları
Veri Tazeliği Neden Önemli?
RAG’ın fine-tuning’e göre en büyük avantajlarından biri, kaynak verinin güncellenmesiyle sistemin neredeyse anında güncel bilgi vermeye başlamasıdır. Ancak bu avantajın gerçekleşmesi için veri kaynağının düzenli olarak yeniden indekslenmesi gerekiyor; eski ve güncelliğini yitirmiş belgelerin vektör veritabanında kalması, modelin yanlış veya eski bilgiye dayanarak yanıt vermesine yol açabilir.
Sık Sorulan Sorular
RAG nedir, kısaca nasıl özetlenir?
RAG nedir sorusunun kısa yanıtı şu: bir dil modelinin, cevap üretmeden önce harici bir kaynaktan ilgili bilgiyi arayıp bu bilgiyi yanıtına dahil etmesini sağlayan bir mimaridir. Bu sayede model, eğitim verisinin ötesinde güncel ve doğrulanabilir bilgiye erişebilir.
RAG kurmak için vektör veritabanı şart mı?
Hayır. Anahtar kelime/BM25, SQL, vektör veya hibrit erişim kullanılabilir. RAG’ı tanımlayan unsur erişilen bilgiyle üretimi desteklemektir; vektör veritabanı yalnız seçeneklerden biridir.
RAG, modelin yanlış bilgi üretmesini (halüsinasyon) tamamen önler mi?
Hayır, tamamen önlemez ama azaltmaya yardımcı olur. Model yine de bulduğu belgeleri yanlış yorumlayabilir veya yetersiz bağlamla yanıt üretebilir; bu nedenle çıktıların düzenli olarak test edilmesi önerilir.
RAG ile fine-tuning aynı anda kullanılabilir mi?
Evet, birçok kurumsal sistemde iki yöntem birlikte kullanılır. Fine-tuning modelin genel davranışını ve üslubunu şekillendirirken, RAG güncel ve değişken bilgiyi sağlar.
Küçük bir ekip RAG sistemini nasıl test edebilir?
Az sayıda belgeyle (örneğin 50-100 sayfalık bir doküman kümesiyle) başlayıp açık kaynak bir embedding modeli ve hafif bir vektör veritabanı ile küçük ölçekli bir prototip kurmak, sistemin davranışını görmek için pratik bir başlangıç noktasıdır.
Erişim Kalitesini Üretimden Ayrı Test Edin
Önce doğru belgenin ilk sonuçlarda bulunup bulunmadığını, sonra yanıtın belgeye sadakatini ölçün. Belge erişim izinlerini retrieval sırasında uygulayın; prompt’a “gizli bilgiyi gösterme” yazmak yetkilendirme değildir. Kaynak belgedeki talimatları güvenilmeyen veri sayın. Belge silme/güncellemesini indeks, embedding ve yanıt önbelleğine birlikte yansıtın. Temel kavram için RAG giriş rehberini okuyabilirsiniz.