
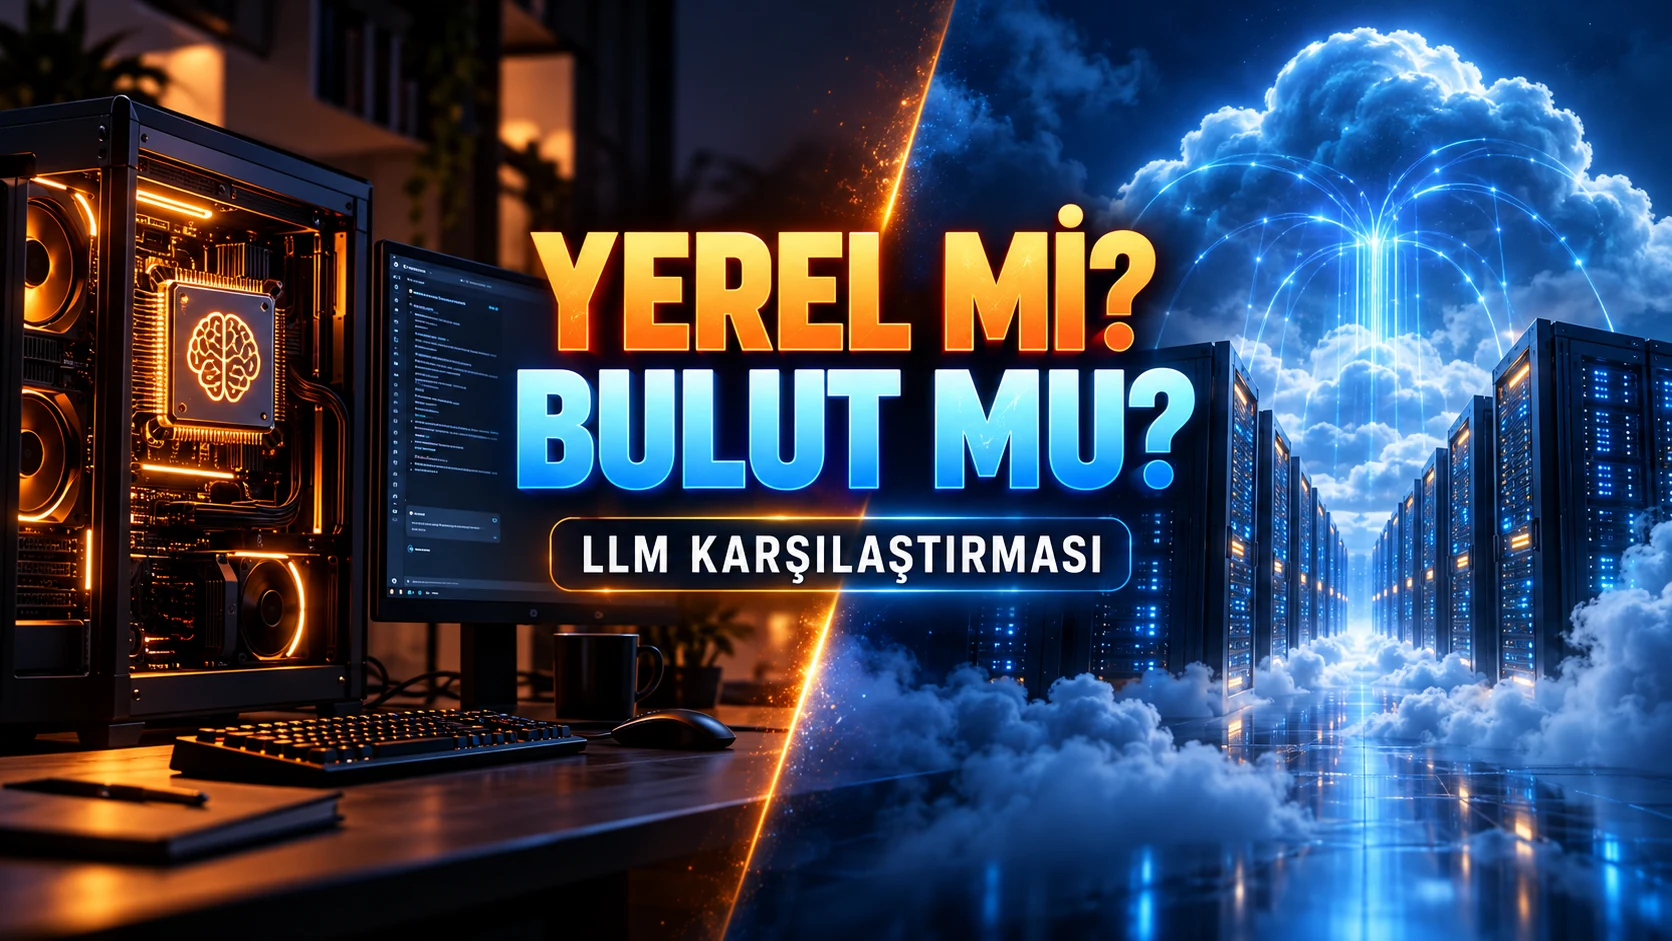
Local LLM ve Cloud API tercihi, çoğu projede “hangisi daha güçlü?” sorusundan çok “hangisi bu iş yükünü, bu bütçeyle ve bu gizlilik gereksinimiyle sürdürülebilir biçimde karşılar?” sorusunun yanıtıdır. İki yaklaşımın da net üstünlükleri ve gizli maliyetleri vardır.
Bu karşılaştırmada iki modeli maliyet, gecikme, kalite, bakım yükü, gizlilik ve ölçeklenebilirlik başlıklarında ele alıyor; sonunda karar vermenizi kolaylaştıran bir senaryo tablosu ve hibrit mimari önerisi sunuyoruz.
Local LLM ve Cloud API: temel fark nerede?
Cloud API kullanımında model sağlayıcının altyapısında çalışır; siz yalnızca istek gönderir ve tükettiğiniz token kadar ödersiniz. Donanım, güncelleme ve ölçekleme sizin sorumluluğunuzda değildir. Local LLM ise modeli kendi sunucunuzda çalıştırmanız demektir: veri dışarı çıkmaz, istek başına ücret ödemezsiniz; buna karşılık donanım, kurulum ve bakım tamamen size aittir.
Aradaki fark teknik olmaktan çok operasyoneldir. Cloud API’de değişken maliyet ve dışa bağımlılık; local kurulumda sabit maliyet ve iç sorumluluk vardır. Küçük ekipler için ikinci seçenek çoğu zaman göründüğünden pahalıdır, çünkü asıl gider donanım değil, o donanımı ayakta tutan insan zamanıdır.
Gizlilik ve veri yerelliği
Sağlık, finans, hukuk ve kamu projelerinde veri aktarımı ve saklama koşulları ayrıca değerlendirilmelidir. Yerel çalıştırma veri akışını kontrol etmeyi kolaylaştırabilir; ancak güvenlik, erişim yetkisi ve hukuka uygunluk kendiliğinden sağlanmaz. Bulut kullanımında sağlayıcının sözleşmesini, saklama süresini ve bölge seçeneklerini inceleyin.
Maliyet karşılaştırması: token mu, donanım mı?

Cloud API maliyeti doğrusaldır: istek sayısı arttıkça fatura artar. Local kurulumda ise maliyet büyük ölçüde sabittir; GPU yatırımı, elektrik, barındırma ve bakım kalemleri hacimden bağımsız olarak devam eder. Bu nedenle karar, kullanım hacminizin başabaş noktasını aşıp aşmadığına bağlıdır.
| Kalem | Cloud API | Local LLM |
|---|---|---|
| Başlangıç maliyeti | Yok denecek kadar az | GPU, sunucu ve kurulum yatırımı |
| Değişken maliyet | Token başına ücret | Elektrik ve barındırma |
| Bakım | Sağlayıcıda | Ekipte: sürüm, güvenlik, izleme |
| Ölçekleme | Anında, limitler dâhilinde | Yeni donanım gerektirir |
| Kesinti riski | Sağlayıcı kaynaklı | Kendi altyapınız kaynaklı |
| Gizlilik | Sözleşmeye bağlı | Veri sunucudan çıkmaz |
Düşük ve orta hacimde bulut API ekonomik olabilir, ancak karar girdi ve çıktı uzunluğu, model fiyatı, donanımın doluluk oranı ve bakım emeğine bağlıdır. Önce iş yükünü ölçün; yalnızca tahmini istek sayısına dayanmayın.
Kalite, gecikme ve bakım yükü
Kalite karşılaştırmasını tek bir sıralamayla yapmak yanıltıcıdır. Sınıflandırma, etiketleme, kısa özetleme ve şablon doldurma gibi görevlerde küçük ve yerel modeller çoğu zaman yeterlidir. Uzun bağlamlı akıl yürütme, çok adımlı araç kullanımı ve yaratıcı üretimde ise büyük sağlayıcı modelleri hâlâ belirgin biçimde öndedir.
Gecikme tarafında local kurulum, ağ turunu ortadan kaldırdığı için ilk token süresinde avantajlı olabilir; ancak yetersiz donanımda üretim hızı hızla düşer. Cloud tarafında gecikmeyi kullanıcıya kısa hissettirmenin en etkili yolu akış (streaming) yanıt kullanımıdır.
Bakım yükü çoğu zaman hafife alınır
Local kurulumda model sürümleri, sürücü uyumu, bellek yönetimi, kuyruk yönetimi ve güvenlik yamaları sizin sorumluluğunuzdadır. Tek kişilik ekiplerde bu yük, elde edilen tasarrufu kısa sürede götürür. Cloud tarafında ise sorumluluk sağlayıcıya geçer; buna karşılık limit ve hata yönetimini siz kurgularsınız. Bu konuda rate limit hatası çözümü ve OpenAI API hataları yazıları pratik başvuru kaynağıdır.
Hangi senaryoda hangisi daha mantıklı?
| Senaryo | Önerilen yaklaşım | Gerekçe |
|---|---|---|
| Yeni ürün, belirsiz talep | Cloud API | Yatırım yapmadan hızlı doğrulama |
| Kişisel veri işleyen kurumsal sistem | Local LLM | Verinin dışarı çıkmaması zorunluluğu |
| Yüksek hacimli, basit sınıflandırma | Local LLM | Küçük model yeterli, hacim maliyeti amorti eder |
| Karmaşık akıl yürütme ve araç kullanımı | Cloud API | Model kalitesi belirleyici |
| Kesintiye tahammülsüz kritik akış | Hibrit | Biri düşerse diğeri devreye girer |
| Kısıtlı ekip, tek geliştirici | Cloud API | Bakım yükü taşınabilir değil |
Hibrit mimari: ikisini birlikte kullanmak

Pratikte en dengeli çözüm çoğu zaman hibrit yaklaşımdır. Basit ve hacimli görevler yerel modele, karmaşık görevler bulut modeline yönlendirilir. Yönlendirme kararı; girdi uzunluğu, görev tipi ve güven eşiğine göre kodda verilir.
Bu mimaride ortak katman genellikle RAG sistemidir: bilgi tabanı ve embedding üretimi yerelde tutulurken yalnızca yanıt üretimi buluta gidebilir. Böylece hem veri hacminin büyük kısmı içeride kalır hem de kalite korunur. Sağlayıcı seçimini netleştirmek için Claude, OpenAI ve Gemini API karşılaştırması yazısı yardımcı olur.
Karar öncesi kontrol listesi
- Aylık istek hacminiz ve ortalama token tüketiminiz ölçüldü mü?
- Verinin ülke dışına çıkmasına engel bir yasal yükümlülük var mı?
- Görevleriniz gerçekten büyük model gerektiriyor mu, küçük modelle test edildi mi?
- Local kurulumda bakımı kim üstlenecek, yedeklilik nasıl sağlanacak?
- Cloud tarafında limit aşımı ve kesinti senaryosu için yedek plan var mı?
- Maliyet karşılaştırması insan zamanı dâhil edilerek yapıldı mı?
- Sağlayıcı değiştirmeniz gerekirse kod tabanınız buna hazır mı?
Kararı bir pilot çalışmayla nasıl verirsiniz?
İlk adım, üretimde karşılaşacağınız görevleri temsil eden küçük bir test kümesi oluşturmaktır. Sadece kolay sorular seçerseniz hem yerel hem bulut çözümü olduğundan iyi görünür. Kısa sınıflandırma, uzun özet, Türkçe özel adlar, hatalı kullanıcı girdileri ve bilgi tabanından yanıt üretme gibi gerçek görevleri ayrı gruplandırın. Her grupta beklenen cevabı veya kabul ölçütünü yazın. Bu sayede “model çok iyi” yerine hangi işte yeterli olduğunu söyleyebilirsiniz.
İkinci adım, aynı girdileri iki çözümde de mümkün olduğunca eşit ayarlarla denemektir. Girdi yönergesi, azami çıktı uzunluğu ve varsa bilgi erişim katmanı farklıysa sonuçların nedeni belirsizleşir. Yanıt kalitesini insan gözden geçirmesiyle veya göreve uygun testlerle ölçün. Sadece birkaç etkileyici örneğe bakmak, üretimdeki hata oranını göstermez. Değerlendirme için en azından doğru, kısmen doğru ve hatalı sonuçların sayısını kaydedin.
Üçüncü adım, gecikme ve maliyet ölçümüdür. İlk yanıt süresi ile tüm yanıtın bitme süresini ayrı tutun. Yerelde boşta bekleyen sunucunun giderini de hesaplayın; bulutta yeniden deneme ve başarısız istekleri de hesaba katın. İş yükü gün içinde dalgalanıyorsa ortalama trafik yerine yoğun saat kapasitesini değerlendirin. Küçük bir pilot, teorik fiyat hesaplarından daha gerçekçi karar verir.
Gerçek toplam maliyet nasıl hesaplanır?
Bulut API maliyetinde girdi, çıktı, önbelleğe alınan girdi, araç çağrıları ve varsa görsel veya ses işlemleri farklı ücretlendirilebilir. Güncel fiyat tablosunu seçtiğiniz sağlayıcının kendi sayfasından okuyun; internetten alınan eski bir rakamı kararın temeline koymayın. Her görev için ortalama ve yüksek yüzdelik dilimdeki token kullanımını ölçün. Uzun bağlamlı istekler bazen az sayıdaki müşteri tarafından oluşturulsa da faturanın önemli kısmını açıklayabilir.
Yerel çözümde donanım alımını kullanım ömrüne yayın; elektrik, soğutma, barındırma, yedek sunucu, depolama ve bakım emeğini ekleyin. Kiralık GPU kullanıyorsanız bu artık tamamen sabit maliyet değildir; çalışma saatine veya kapasiteye göre değişir. Satın alınmış donanımda da elektrik ve arıza giderleri talep arttıkça yükselebilir. “Yerelde istek başına ücret yok” ifadesi marjinal fatura açısından doğru görünse bile toplam maliyeti sıfır yapmaz.
Basit bir karşılaştırmada aylık toplam maliyeti başarılı yanıt sayısına bölün. Sonra aynı hesabı görev türleri için ayrı yapın. Model ucuz fakat hata oranı yüksekse insan düzeltme süresi farkı kapatabilir. Ayrıca trafik iki katına çıktığında ne olacağını senaryo olarak çalışın: bulut faturası artar, yerelde ise kapasite sınırına ulaştığınızda yeni makine gerekebilir. Kesin bir başabaş noktası her proje için farklıdır.
Gizlilik ve güvenlik kararını nasıl verirsiniz?
“Yerel” sözcüğü tek başına verinin hiç dışarı çıkmadığını kanıtlamaz. Kullanılan arayüz, hata raporlama hizmeti, uzaktan izleme, model indirme kaynağı ve yedekleme sisteminin veri akışını inceleyin. Kendi sunucunuzda çalışan model bile yanlış yapılandırılmış bir günlük sistemine hassas girdileri yazabilir. Önce veri sınıflarını çıkarın: herkese açık, kurum içi, kişisel ve özel nitelikli veriler aynı kurala tabi değildir.
Bulut tarafında sağlayıcı sözleşmesi, veri saklama ve eğitimde kullanım politikası, veri işleme bölgesi, erişim günlükleri ve silme süreci incelenmelidir. Bu belgeler zamanla değişebildiğinden üretim kararı öncesinde güncel sürümlerine bakın. Gizlilik gereği varsa hukuki ve güvenlik ekiplerinin değerlendirmesini alın. Yerel çalıştırma ağ dışına çıkışı azaltabilir, fakat erişim kontrolü, şifreleme, yama ve olay müdahalesi kurumun sorumluluğunda kalır.
Kaliteyi yalnızca model büyüklüğüyle ölçmeyin
Bir modelin parametre sayısı, Türkçe bir destek mesajını doğru sınıflandırıp sınıflandırmayacağını tek başına söylemez. Eğitim verisi, yönerge takibi, bağlam uzunluğu, nicemleme ayarı ve servis yazılımı sonucu etkiler. Büyük model düşük donanımda yavaş çalışıyorsa kullanıcı deneyimi küçük ama hızlı bir modelden kötü olabilir. Test kümenizi kendi alanınızdan kurmak bu nedenle önemlidir.
Nicemleme daha az bellekle çalışmayı sağlayabilir; buna karşılık bazı görevlerde kalite değişebilir. Aynı modelin farklı nicemleme sürümlerini tek model gibi raporlamayın. Ayrıca uzun bağlam sınırına yakın isteklerde bellek ve gecikme etkisini ölçün. Üretimde gönderilen istemlerin çoğu kısaysa devasa bağlam penceresi için ödeme yapmak gereksiz olabilir.
Bulut hizmetinde model sürümleri ve varsayılan davranışlar değişebilir. Yerel çözümde sürümü siz sabitleyebilirsiniz, fakat güvenlik güncellemesini ve yeni model geçişini de siz yönetirsiniz. Her iki yaklaşım için örnek testleri sürüm değişiminde tekrar çalıştırmak iyi bir alışkanlıktır. Kalite kararı ürün pazarlama metnine değil ölçtüğünüz görev sonuçlarına dayanmalıdır.
Hibrit mimaride en önemli sınır veri akışıdır
Basit işler yerelde, zor işler bulutta çalıştırılabilir; ancak hangi girdinin “zor” olduğundan önce hangisinin dışarı aktarılabileceği belirlenmelidir. Kişisel bilgi içeren bir isteği, yerel modelden düşük güven puanı aldı diye otomatik olarak buluta göndermek gizlilik politikasını bozabilir. Yönlendirici önce veri sınıfını denetlemeli, sonra kalite ve maliyet kararını vermelidir. Gerekiyorsa hassas alanları maskeleyin; fakat maskelemenin görevi anlamsız hale getirip getirmediğini test edin.
RAG sisteminde belge deposu yerelde kalsa bile bulut modeline gönderdiğiniz alıntı parçaları veriyi dışarı taşır. “Veri tabanı içeride” ifadesi bu nedenle tam bir güvence değildir. İstek kayıtlarında hangi parçanın hangi sağlayıcıya gittiğini ölçün. Hem güvenlik denetimi hem maliyet analizi için bu kayıt yararlıdır; ancak günlüklerin kendisi de hassas veri içerebileceği için saklama süresi ve erişimi sınırlandırılmalıdır.
Bir sağlayıcıya bağımlılığı azaltmak istiyorsanız yalnızca API uç noktasını soyutlamak yetmez. Farklı sağlayıcıların araç çağırma biçimi, hata kodu, hız sınırı ve yapılandırılmış çıktı desteği değişebilir. Kritik görevler için alternatif sağlayıcıyı önceden test edin. Kesinti anında otomatik geçiş uygulayacaksanız yanıt kalitesi, maliyet ve veri aktarım izninin aynı kaldığını doğrulayın.
Uygulama öncesi kısa kontrol listesi
Gerçek görevleri temsil eden test seti hazır mı? Kaliteyi değerlendiren kişi ve ölçüt belli mi? Aylık token ve yoğun saat istek sayısı ölçüldü mü? Yerel sunucunun arıza ve bakım gideri hesaplandı mı? Dışarı aktarılabilecek veri sınıfları belirlendi mi? Kesinti, kota aşımı ve model sürümü değişikliği için geri dönüş planı var mı? Bu soruların yanıtları tamamlanmadan yalnızca model demosuna bakarak mimari seçmeyin.
Pilot bittikten sonra kararı bir kez verip unutmayın. Kullanım hacmi, model kalitesi ve sağlayıcı fiyatları değiştikçe karşılaştırmayı yenileyin. İlk aşamada bulut doğru, büyüyen ve düzenli yükte yerel veya hibrit doğru olabilir; tersi de mümkündür. Geçiş kararı için eşikleri önceden yazmak, tek bir yüksek faturaya tepkiyle acele donanım almanızı önler.
Karar notuna pilot tarihini, kullanılan model sürümlerini, örnek sayısını ve ölçüm koşullarını ekleyin. Böylece altı ay sonra aynı soruyu değerlendirirken eski sonucun hangi şartlarda geçerli olduğunu anlayabilirsiniz.
Sıkça Sorulan Sorular
Local LLM her zaman daha mı ucuzdur?
Hayır. Yalnızca yüksek ve düzenli hacimde ucuzlar. Düşük hacimde donanım ve bakım maliyeti, ödeyeceğiniz token ücretinin çok üzerinde kalır.
Yerel modeller büyük sağlayıcı modellerinin yerini tutar mı?
Görev tipine bağlıdır. Sınıflandırma, etiketleme ve şablonlu üretimde fark küçüktür; uzun bağlamlı akıl yürütmede fark hâlâ belirgindir.
Hangi donanım gerekir?
Belirleyici olan model boyutu ve nicemleme (quantization) seviyesidir. Küçük modeller tek bir orta seviye GPU ile çalışabilirken büyük modeller yüksek VRAM ve uygun soğutma gerektirir.
Gizlilik için tek çözüm local kurulum mudur?
Hayır. Veri maskeleme, kişisel alanların istek öncesi temizlenmesi ve sözleşmeli veri işleme koşulları çoğu senaryoda yeterli olabilir. Karar, tabi olduğunuz mevzuata göre verilmelidir.
Sağlayıcıya bağımlılıktan nasıl kaçınırım?
İstek katmanını soyutlayın; model adı, uç nokta ve yanıt biçimini tek bir servis sınıfında toplayın. Böylece sağlayıcı değişimi tek dosyada çözülür.
Hibrit mimaride yönlendirme kararını neye göre veririm?
Girdi uzunluğu, görev tipi ve yerel modelin güven skoru üçlüsü pratikte yeterlidir. Eşik altındaki yanıtlar buluta devredilir.
Destek botu gibi kullanıcıya açık bir üründe hangisi tercih edilmeli?
Genellikle cloud API ile başlanır; hacim ve gizlilik gereksinimi büyüdükçe hibrit modele geçilir. Kurulum ayrıntıları için yapay zeka destekli müşteri destek botu yazısına bakabilirsiniz.
Kaynaklar
- llama.cpp — yerel çalıştırma projesi
- vLLM dokümantasyonu — yüksek verimli sunum
- Hugging Face dokümantasyonu
- OpenAI Platform — gecikme optimizasyonu rehberi
Sonuç
Local LLM ve Cloud API arasındaki seçim, teknik bir üstünlük yarışı değil; hacim, gizlilik ve ekip kapasitesi denklemidir. Çoğu proje cloud API ile başlayıp ölçüm verisi biriktikten sonra hibrit mimariye geçtiğinde hem maliyeti hem riski dengede tutar.
İlgili rehberler:
- Claude, OpenAI ve Gemini API Karşılaştırması
- AI API Kullanırken Token Maliyeti Nasıl Azaltılır?
- RAG Sistemi Nedir ve Web Sitesine Nasıl Eklenir?
- Embeddings Nedir, Nasıl Kullanılır?
- Yapay Zeka Destekli Müşteri Destek Botu Nasıl Yapılır?
Konuyu tek bir entegrasyonun bütünü içinde görmek isterseniz AI API Entegrasyonu Rehberi sayfası, ilk API çağrısından RAG sistemine kadar sıralı bir yol haritası sunuyor.
Kaynaklar ve İleri Okuma
Resmî dokümantasyon
Sitedeki ilgili rehberler