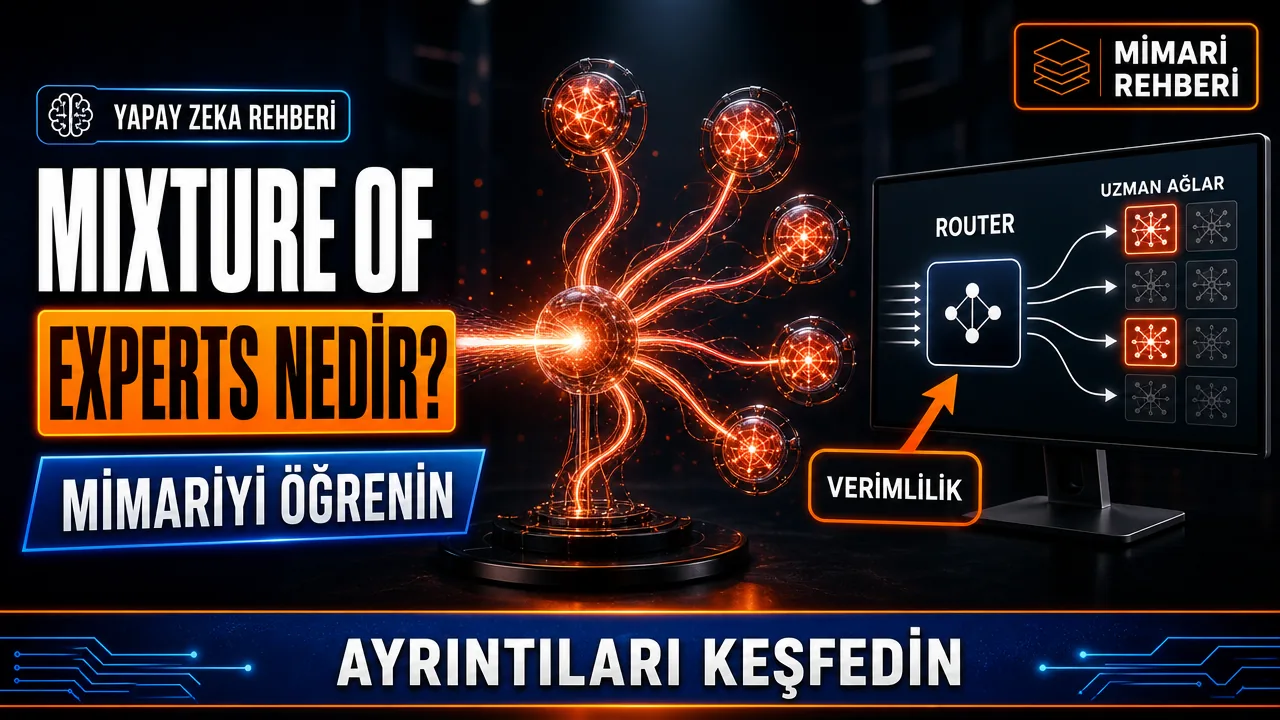
Mixture of Experts (MoE), yaygın Transformer uygulamalarında ileri besleme katmanındaki birden fazla uzman ağdan her token için yalnızca seçilenlerini çalıştıran bir yaklaşımdır. Uzmanlar bağımsız sohbet modelleri veya önceden “matematik uzmanı” diye atanmış ajanlar değildir; router ve uzman ağlar eğitimde öğrenilir. Paylaşılan dikkat ve diğer katmanların maliyeti devam eder.
Mixture of Experts Nedir, Nasıl Çalışır?
Yoğun Transformer’ın ileri besleme blokları her token için çalışırken, seyrek MoE blokları uzmanların bir alt kümesini seçer. “Yoğun modelin her parametresi her token’da kullanılır” ifadesi özellikle embedding tablosu için fazla geneldir. MoE avantajını toplam parametre ile token başına aktif parametreyi ayırarak değerlendirin.
Bu yaklaşımın temel mantığı şudur: model toplamda çok büyük bir parametre havuzuna sahip olabilir, ancak her token yalnızca bu havuzun küçük bir bölümünü kullanır. Böylece model “bilgi kapasitesi” açısından büyük, ama “hesaplama maliyeti” açısından çok daha hafif çalışabilir.
Yönlendirme (Routing) Mekanizması
Yönlendirme ağı, her token için uzmanlara bir ağırlık puanı atar ve genellikle bu puanlar üzerinden “top-k” seçimi yapılır; yani en yüksek puan alan k adet uzman devreye girer. Yaygın yöntemlerden biri softmax tabanlı yönlendirme, bir diğeri ise yük dengelemesi için gürültü eklenen “noisy top-k” yaklaşımıdır. Yük dengeleme burada kritik bir konu: bazı uzmanlar aşırı yüklenirken bazıları hiç kullanılmazsa, modelin eğitim verimliliği düşer. Bu yüzden MoE mimarilerinde genellikle ek bir “yük dengeleme kaybı” (load balancing loss) terimi eğitime dahil edilir.
Mixture of Experts’in Avantajları
- Daha hızlı ön eğitim: Aynı hesaplama bütçesiyle yoğun modellere kıyasla daha hızlı eğitim mümkün oluyor.
- Daha hızlı çıkarım (inference): Toplam parametre sayısı yüksek olsa da token başına yalnızca bir alt küme aktifleştiği için çıkarım hızı, benzer boyuttaki yoğun bir modelden daha iyi olabiliyor.
- Ölçeklenebilirlik: Sabit bir hesaplama bütçesi içinde model kapasitesini artırmak mümkün; araştırmacılar model boyutunu veya veri setini daha esnek şekilde büyütebiliyor.
Mixture of Experts’in Dezavantajları
- Yüksek toplam bellek ihtiyacı: Uzman ağırlıkları saklanmalıdır; tek GPU’ya yüklenmeleri zorunlu değildir. Expert parallelism, CPU offload ve niceleme düzeni bellek yerleşimini değiştirir; bunların aktarım maliyeti de vardır.
- İnce ayar (fine-tuning) zorlukları: Seyrek modeller, özellikle küçük ve akıl yürütme ağırlıklı veri setlerinde daha kolay aşırı öğrenmeye (overfitting) eğilimli olabiliyor.
- Mühendislik karmaşıklığı: Yönlendirme mekanizmasının dengeli çalışması, dağıtık eğitim altyapısının doğru kurgulanması gibi ek mühendislik gereksinimleri var.
Mixture of Experts Fikri Nereden Geliyor?
Uzman karışımı fikri aslında yapay zekâ literatüründe yeni değil; 1990’ların başında sinir ağlarını birden fazla alt uzman modele bölme fikri akademik makalelerde tartışılmaya başlanmıştı. Ancak bu yaklaşımın büyük dil modellerinde pratik ve ölçeklenebilir hale gelmesi, Google’ın Switch Transformer çalışmasıyla ve sonrasında Mistral’in Mixtral serisiyle mümkün oldu. Günümüzde artan hesaplama maliyetleri ve GPU tedarik kısıtları, MoE mimarisini akademik bir merak konusu olmaktan çıkarıp neredeyse tüm büyük laboratuvarların başvurduğu pratik bir çözüme dönüştürdü.
Bilinen Mixture of Experts Modelleri
| Model | Geliştirici | Öne Çıkan Özellik |
|---|---|---|
| Mixtral 8x7B | Mistral AI | 46,7 milyar toplam; token başına 12,9 milyar aktif parametre |
| Switch Transformer | 2.048 uzmana kadar ölçeklenen erken dönem MoE mimarisi | |
| DeepSeek V4.1-Flash | DeepSeek | 552 milyar parametrelik omurga, token başına sınırlı aktivasyon |
| NLLB MoE | Meta | Çeviri görevlerine özel uzmanlaşmış mimari |
MoE ve Yoğun (Dense) Modeller Arasındaki Fark
Model kartındaki router, uzman sayısı ve aktif/toplam parametre bilgilerini birlikte okuyun. DeepSeek V4.1-Flash kartı 552B omurga ve ayrıca 196B Engram parametresi bildiriyor; prefill/decode aktif sayıları 8B/16B olarak ayrılıyor. Aktif parametreyi toplam VRAM gereksinimi veya doğrudan token/s hızına eşitlemeyin. RAG rehberimiz dış bilgi erişimini anlatır; MoE iç model mimarisidir.
Kontrol Listesi: Bir Modelin MoE Olup Olmadığını Anlamak
- Model kartında “aktif parametre” ve “toplam parametre” rakamlarının ayrı verilip verilmediğine bakın.
- Teknik dokümantasyonda “router”, “gating network” veya “uzman” (expert) gibi terimlerin geçip geçmediğini kontrol edin.
- Kendi altyapınızda çalıştıracaksanız, VRAM gereksinimini toplam parametre sayısına göre hesaplayın; aktif parametre sayısına göre değil.
- İnce ayar yapacaksanız, seçtiğiniz kütüphanenin (örneğin Hugging Face Transformers, vLLM) MoE mimarisini resmi olarak desteklediğinden emin olun.
Pratikte Ne Zaman Tercih Edilmeli?
Sınırlı bir hesaplama bütçesiyle mümkün olan en yüksek model kapasitesine ulaşmak isteyen araştırma ekipleri için MoE mimarisi çekici bir seçenek. Ancak sınırlı GPU belleğine sahip küçük ölçekli projelerde, tüm uzmanların belleğe yüklenmesi gerektiği için MoE her zaman en pratik seçim olmayabilir. Böyle durumlarda daha küçük yoğun bir modeli fine-tuning ile özelleştirmek genellikle daha yönetilebilir bir yol sunuyor.
Geliştiriciler İçin Pratik Notlar
MoE tabanlı bir modeli üretime almadan önce dikkat edilmesi gereken birkaç pratik nokta var. Öncelikle, çıkarım motorunuzun (vLLM, SGLang, TGI gibi) kullandığınız spesifik MoE varyantını (örneğin belirli bir yönlendirme algoritmasını) desteklediğini doğrulamak gerekiyor; her çıkarım motoru her MoE mimarisini aynı verimlilikte çalıştırmayabiliyor. İkinci olarak, dağıtık ortamlarda uzmanların farklı GPU’lara dağıtılması (expert parallelism) ağ trafiğini artırabileceğinden, ağ bant genişliğinin de bir darboğaz oluşturup oluşturmadığı test edilmeli. Son olarak, maliyet karşılaştırması yaparken yalnızca token başına ücrete değil, aynı kalitedeki yoğun bir modele göre toplam altyapı maliyetine de bakmakta fayda var.
Sıkça Sorulan Sorular
Mixture of Experts nedir, kısaca nasıl özetlenir?
Mixture of Experts, bir yapay zekâ modelini birden fazla küçük uzman ağa bölen ve her girdi için yalnızca ilgili uzmanları devreye sokan bir mimari yaklaşımdır. Amaç, model kapasitesini artırırken hesaplama maliyetini kontrol altında tutmaktır.
MoE modelleri her zaman daha mı hızlı çalışır?
Token başına aktif parametre sayısı düşük olduğu için çıkarım genellikle daha hızlı olabilir, ancak tüm uzmanların belleğe yüklenmesi gerektiğinden bellek darboğazı yaşanırsa bu avantaj ortadan kalkabilir.
Mixtral gibi modeller neden MoE tercih ediyor?
Mixtral gibi modeller, daha büyük bir model havuzundan faydalanarak kalite artışı sağlarken, aktif parametre sayısını sınırlı tutarak çıkarım maliyetini yönetilebilir seviyede tutmayı hedefliyor.
MoE mimarisi ile fine-tuning arasında ilişki var mı?
Evet, MoE modellerinin ince ayarı, yönlendirme dengesizliği ve aşırı öğrenme riski nedeniyle yoğun modellere göre daha dikkatli bir süreç gerektirir; genellikle daha küçük öğrenme oranları ve dikkatli veri seçimi öneriliyor.
Küçük bir ekip MoE modeli çalıştırabilir mi?
Açık kaynaklı MoE modellerini API üzerinden kullanmak mümkün; ancak modeli kendi sunucusunda barındırmak isteyen küçük ekiplerin, toplam parametre sayısına göre hesaplanan VRAM ihtiyacını önceden değerlendirmesi gerekir.
Mixtral’deki aktif parametre sayısı, herhangi bir 12,9B yoğun modelle her donanımda aynı hızın elde edileceği anlamına gelmez. Batch, bağlam, uzman yönlendirmesi, iletişim ve kernel desteği ölçülmelidir. VRAM planına ağırlıklar dışında KV cache, çalışma alanı ve paralellik giderlerini ekleyin.
Teknik kaynak: Mistral — Mixtral mimarisi.