
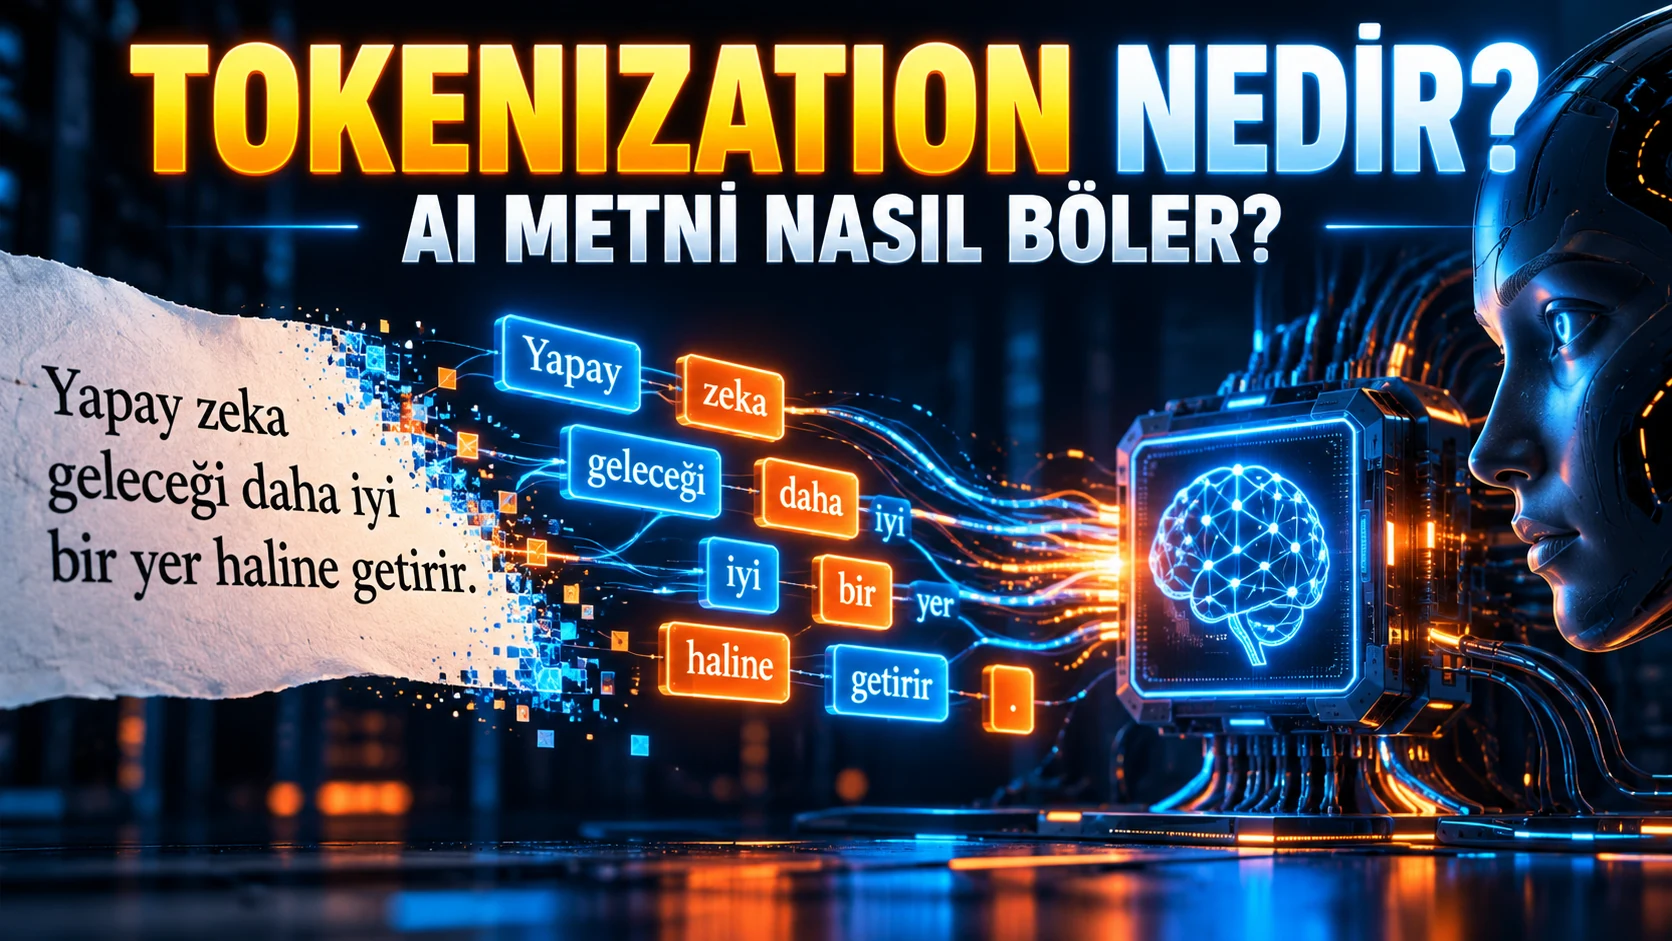
Tokenization nedir? Tokenization (Türkçe karşılığıyla “belirteçleme” veya “parçalama”), bir yapay zeka dil modelinin okuduğu metni “token” adı verilen küçük birimlere ayırma işlemidir. ChatGPT, Claude veya Gemini gibi büyük dil modelleri (LLM) metni doğrudan kelime kelime değil, bu token birimleri üzerinden işler; her token bir kelimenin tamamı, bir hecesi ya da tek bir karakter bile olabilir. Bu makalede tokenization’ın nasıl çalıştığını, neden önemli olduğunu ve API maliyetlerini nasıl etkilediğini adım adım ele alıyoruz.
Tokenization Nedir, Neden Gerekli?

Bilgisayarlar metni doğrudan “anlamaz”; sayılarla çalışır. Bir dil modelinin metni işleyebilmesi için önce onu sayısal bir forma çevirmesi gerekir. Tokenization, bu dönüşümün ilk adımıdır: metin önce token adı verilen parçalara bölünür, ardından her token bir sayısal kimliğe (token ID) eşlenir. Model, bu sayısal dizi üzerinden hesaplama yapar ve çıktısını yine token dizisi olarak üretir; son adımda bu diziler tekrar okunabilir metne çevrilir.
Kelime, Karakter ve Alt Kelime (Subword) Farkı
Tokenization yöntemleri üç ana yaklaşımda toplanabilir:
- Kelime bazlı: Her kelime tek bir token’dır. Basit ama büyük bir sözlük gerektirir ve yeni/nadir kelimelerde zorlanır.
- Karakter bazlı: Her harf bir token’dır. Sözlük çok küçüktür ama diziler çok uzar, bu da işlem maliyetini artırır.
- Alt kelime (subword) bazlı: Günümüz büyük dil modellerinin çoğunun kullandığı yöntem. Sık kullanılan kelimeler tek token olarak kalırken, nadir veya uzun kelimeler daha küçük parçalara bölünür. BPE bir alt kelime algoritmasıdır; SentencePiece ise BPE veya Unigram gibi yöntemleri uygulayabilen bir araçtır.
Örneğin İngilizce’de “tokenization” kelimesi bazı modellerde “token” ve “ization” olarak iki parçaya bölünebilir; Türkçe gibi eklemeli bir dilde ise “kitaplarımızdan” gibi uzun bir kelime çok daha fazla token’a bölünebilir. Bu da Türkçe metinlerin, eşdeğer İngilizce metinlere göre genellikle daha fazla token tükettiği anlamına gelir.
Tokenization API Maliyetini Nasıl Etkiler?

OpenAI, Anthropic ve Google gibi sağlayıcıların çoğu, API ücretlendirmesini token sayısı üzerinden yapar; yani ödediğiniz ücret doğrudan gönderdiğiniz ve aldığınız token sayısına bağlıdır. Bu nedenle tokenization mantığını anlamak, sadece teknik bir merak değil, aynı zamanda pratik bir maliyet yönetimi konusu.
import tiktoken

encoding = tiktoken.get_encoding("cl100k_base")
metin = "Yapay zeka modelleri metni token'lara ayırarak işler."
tokenlar = encoding.encode(metin)

print("Token sayısı:", len(tokenlar))
print("Token ID'leri:", tokenlar)
Yukarıdaki gibi bir Python betiği, gerçek bir API çağrısı yapmadan önce metninizin kaç token tuttuğunu hesaplamanızı sağlar. Bu, özellikle uzun prompt’lar veya toplu işlem (batch) senaryolarında bütçe planlaması için pratik bir kontrol noktasıdır.
Bağlam Penceresi (Context Window) ile İlişkisi
Bağlam sınırı aşılırsa hizmet hata döndürebilir; geçmişi kesme/özetleme uygulama veya API seçeneğine bağlıdır. Modelin kendiliğinden her zaman eski mesajları attığı varsayılmamalıdır. Mesaj şeması, araç tanımları, görsel/ses ve bazı modellerde akıl yürütme bütçesi de hesaplamaya dahil olabilir.
| Yöntem | Kullanan Modeller (örnek) | Özellik |
|---|---|---|
| Byte Pair Encoding (BPE) | GPT ailesi modelleri | Sık geçen karakter çiftlerini birleştirerek sözlük oluşturur |
| SentencePiece | Birçok açık kaynak model | Boşlukları da token olarak ele alabilir, dilden bağımsız çalışır |
| WordPiece | BERT tabanlı modeller | Alt kelime sözlüğü oluşturur; ayrıştırma BPE ile aynı işlem değildir |
Token Sayısını Azaltmak İçin Pratik Yöntemler
Uygulama geliştirenler için token verimliliği doğrudan maliyet ve hız demek. Aşağıdaki kontrol listesi, bir AI entegrasyonu kurarken gözden geçirilebilecek temel noktaları özetliyor:
- Gereksiz tekrar eden talimat metinlerini system prompt içinde sadeleştirin; her istekte aynı uzun açıklamayı göndermek yerine kısa ve net talimatlar kullanın.
- Uzun konuşma geçmişini tamamen göndermek yerine, özet (summarization) tekniğiyle geçmişi sıkıştırın.
- Kod veya JSON gibi yapılandırılmış veri gönderirken gereksiz boşluk ve girinti karakterlerini azaltın; bunlar da token sayısına dahildir.
- Mümkünse embedding tabanlı bir vektör veritabanı ile yalnızca ilgili metin parçalarını modele iletin, tüm dokümanı değil.
- Sağlayıcının resmi tokenizer aracıyla (örneğin OpenAI’nin tokenizer sayfası) gerçek istek göndermeden önce token sayınızı test edin.
Türkçe İçerikte Tokenization Neden Daha Maliyetli Olabilir?
Çoğu büyük dil modelinin tokenizer’ı İngilizce ağırlıklı veri kümeleriyle eğitildiği için Türkçe gibi eklemeli dillerde kelimeler daha sık parçalanıyor. Pratikte bu, aynı anlamı taşıyan bir Türkçe metnin İngilizce eşdeğerine göre tokenizer ve metne bağlı olarak farklı token tüketebileceği anlamına geliyor. Türkçe içerik üreten veya Türkçe destekli bir chatbot geliştiren ekiplerin bütçe hesaplarını yaparken bu farkı göz önünde bulundurması, sürpriz maliyet artışlarının önüne geçebilir.
Bu konu, otonom yapay zekâ ajanları gibi çok adımlı, uzun bağlamlı sistemlerle de doğrudan ilişkili; çünkü bir ajan her adımda önceki adımların çıktısını tekrar modele gönderdiğinde, token tüketimi katlanarak artabiliyor. Bu nedenle ajan mimarisi kuran ekipler, bağlam yönetimini token verimliliği açısından da planlamalı.
Tokenization ile Embedding Arasındaki Fark
Tokenization ve embedding kavramları sık sık birbirine karıştırılıyor; oysa iki farklı adımı ifade ediyorlar. Tokenization, metni token adlı parçalara bölme ve bu parçaları sayısal kimliklere (token ID) eşleme işlemidir. Embedding ise bir adım sonrasında gerçekleşir: her token ID, modelin anlamsal ilişkileri temsil edebildiği çok boyutlu bir sayı vektörüne dönüştürülür. Basitçe özetlemek gerekirse tokenization “metni parçalara ayırma ve numaralandırma” işiyken, embedding “bu numaralara anlam yükleme” işidir. İki kavram birbirini tamamlar ve bir dil modelinin çalışma hattında art arda uygulanır.
Tokenizer Farklılıkları Neden Modelden Modele Değişir?
Her büyük dil modeli kendi eğitim verisine göre optimize edilmiş bir tokenizer sözlüğü kullanır. Bu yüzden aynı metin, GPT tabanlı bir modelde 42 token’a bölünürken, farklı bir sözlük kullanan başka bir modelde 55 token’a bölünebilir. Bu fark, özellikle çoklu model kullanan (multi-model) sistemlerde maliyet karşılaştırması yaparken göz ardı edilmemesi gereken bir detay. Bir entegrasyonu farklı sağlayıcılar arasında taşımayı planlayan ekiplerin, geçiş öncesinde örnek metinlerle iki tokenizer’ı karşılaştırması, beklenmedik maliyet farklarını erken tespit etmelerine yardımcı olur.
Kelime sayısı ile token sayısını karıştırmayın
Yapay zekâ modelleri metni doğrudan “kelimeler” olarak işlemez. Metin, modele özgü bir tokenlaştırma yöntemiyle parçalara ayrılır. Bir token tam bir kelime, kelimenin parçası veya noktalama işareti olabilir. Türkçe eklemeli bir dil olduğu için bir kelimenin kaç parçaya ayrılacağını İngilizce için söylenen kaba oranlarla güvenilir biçimde tahmin edemezsiniz. Aynı cümle farklı model ailesinde farklı sayıda token oluşturabilir. Bu nedenle maliyet veya bağlam sınırı planlarken karakter sayısına değil ilgili modelin gerçek token sayımına bakın.
Bir kullanıcı “Ürün ne zaman teslim edilir?” diye sorduğunda yalnızca bu görünen cümle gönderilmez. Sistem talimatı, önceki konuşma, çağrılan araçların tanımları ve belge parçaları da isteğin parçası olabilir. Yanıt üretilirken çıktı tokenları ayrıca oluşur. Böylece kısa görünen bir kullanıcı mesajı büyük bir toplam isteğe dönüşebilir. Konuşma geçmişini sınırsız eklemek hem bağlam sınırına yaklaşır hem gereksiz maliyet yaratır. Hangi geçmişin gerçekten gerekli olduğunu seçmek uygulama tasarımının bir parçasıdır.
Tokenlaştırmayı küçük örneklerle test edin
Bir Türkçe cümleyi, emoji içeren bir mesajı, kod bloğunu ve çok uzun URL’yi aynı token sayma aracında karşılaştırın. Sonuçların kelime sayısıyla doğrusal olmadığını göreceksiniz. Bu test, belirli bir model için bütçe belirlerken sezgi yerine ölçüm sağlar. OpenAI’ın temel kavramlar belgesi tokenları sık görülen karakter dizileri olarak açıklar; token sayma rehberi ise gerçek istek yapısının sayımı nasıl etkilediğini anlatır. Bir sağlayıcıdaki örnek diğer modelde aynı sonucu vermeyebilir.
Metin dışı girdiler de hesaba katılmalıdır. Görsel, dosya ve araç şeması kullanan bir uygulamada yerel bir metin tokenlaştırıcısı toplam maliyeti eksik gösterebilir. API sağlayıcısının gerçek istek sayımı varsa onu kullanın. Arayüzde gösterilen “şu kadar kelime” bilgisini bağlam bütçesiyle eşitlemeyin. Özellikle RAG sistemlerinde getirilen belge parçaları token kullanımını hızla büyütür. Daha çok belge eklemek yanıtı her zaman iyileştirmez; ilgisiz metin doğru bilgiyi bastırabilir.
Bağlam penceresi nasıl yönetilir?
Modelin bağlam sınırı, girdiler ve çıktı için kullanılabilen toplam alanı belirler. Tam sınırın dolmasını beklemek iyi tasarım değildir; yanıt için boşluk bırakın. Örneğin uzun bir destek konuşmasının tüm mesajlarını her seferinde tekrar göndermek yerine güncel durumu kısa ve denetlenebilir bir özetle taşıyabilirsiniz. Ancak özetin kritik istisnayı silmediğinden emin olun. Gerektiğinde eski konuşmanın bağlantısı veya kayıt kimliği tutulabilir. Sık kullanılan, değişmeyen kurallar ile kullanıcıya özel güncel bilgiler farklı yönetilmelidir.
RAG yanıtında önce hangi belgelerin gerçekten ilgili olduğunu seçin. Her arama sonucunu tam metin eklemek pahalı ve gürültülüdür. Belge parçaları kaynak ve tarih bilgisiyle gönderilmeli, erişim yetkisi uygulanmalıdır. Bir parçayı kısaltırken koşulları veya uyarıları koparmayın. Yanıt doğruluğunu aynı test sorularıyla izleyin. Token azaltımı maliyeti düşürürken doğru kaynağı dışarıda bırakıyorsa fayda sağlamaz. Ölçümde kalite ve maliyet birlikte raporlanmalıdır.
API maliyetini adım adım hesaplayın
Önce uygulamanın tipik bir isteğinde girdi ve çıktı tokenlarını ölçün. Sonra günlük istek sayısı ve beklenen kullanım artışıyla çarpın. Farklı model ve özelliklerin ücretlendirmesi değişebileceği için güncel sağlayıcı fiyat sayfasını kullanın; bu rehberde sabit tutar vermek çabuk eskir. En uzun yüzde birkaç isteği ayrıca inceleyin. Ortalama düşük olsa bile bazı konuşmalar aşırı uzun olabilir. Kullanıcı başına veya görev başına güvenli üst sınır belirleyin ve sınır yaklaşırken anlaşılır geri bildirim verin.
Önbellekleme veya tekrar kullanılan sistem içeriği için sağlayıcının geçerli kurallarını kontrol edin. Aynı metni her istekte göndermek bazı sistemlerde farklı maliyet veya gecikme yaratabilir. Buna karşılık sırf maliyeti azaltmak için gerekli güvenlik talimatlarını kaldırmak uygun değildir. Önce gereksiz tekrarları ve ilgisiz belge parçalarını ayıklayın. Araç çağrılarının sayısını ve dönen veri miktarını izleyin. Böylece uygulama davranışını bozmadan tasarruf alanı bulunur.
Üretim izlemesi ve hata durumları
Her istek için token kullanımını, model sürümünü, görev türünü ve başarı durumunu kaydedin; kullanıcı metninin tamamını gereksiz yere günlükte saklamayın. Bağlam sınırı hatası veya eksik yanıt yaşandığında hangi bileşenin büyüdüğünü görebilmek gerekir: geçmiş mi, belgeler mi, araç çıktısı mı? Belirli bir sürümden sonra kullanım artıyorsa prompt veya araç şemasındaki değişikliği inceleyin. Token sayısı sadece fatura hesabı değil, mimari davranışın ölçüsüdür.
Bir metnin token sayısını “Türkçede her kelime şu kadardır” diye ezberlemeyin. Modelin tokenlaştırıcısı, mesaj biçimi ve eklenen çoklu ortam öğeleri sonucu değiştirir. Küçük bir ölçüm kümesi hazırlayıp gerçek istekleri saymak daha güvenilir yoldur. Bütçe, bağlam ve yanıt kalitesini birlikte ele aldığınızda tokenizasyon soyut bir teknik ayrıntı olmaktan çıkar, ürün deneyimini yöneten pratik bir karar hâline gelir.
Bir destek botunda pratik bütçe örneği
Destek botu her istekte uzun bir politika metnini, bütün sohbet geçmişini ve aramadan gelen çok sayıda belgeyi modele gönderiyorsa maliyet beklenmedik biçimde artabilir. İlk adım her parçanın token katkısını ayrı kaydetmektir. Sabit sistem yönergesi, seçilmiş geçmiş, arama sonucu ve kullanıcı sorusu ayrı ölçülür. Sonra gereksiz geçmiş kaldırılır, tekrarlanan belge parçaları birleştirilir ve alakasız arama sonuçları elenir. Yanıt kalitesi aynı test sorularında gerilemiyorsa bu sadeleştirme gerçek kazanç sağlar.
Destek akışında uzun bir müşteri konuşmasını tek cümleye indirgemek riskli olabilir; daha önce verilen bir söz veya önemli istisna kaybolabilir. Özetleme stratejisi kimin hangi kararı verdiğini, açık kalan soruyu ve doğrulanmış kaynakları korumalıdır. Özetin kalitesi düzenli örneklerle denetlenir. Müşteri kişisel bilgileri de gereksiz taşınmamalıdır. Token azaltımı ve gizlilik çoğu zaman aynı yönde ilerler, fakat önemli bağlamı silmemek için dikkat gerekir.
Girdi ve çıktı dengesini kurun
Bir uygulama yanıt için çok az alan ayırırsa model cümleyi tamamlayamadan durabilir. Çok büyük çıktı üst sınırı ise tek başına her zaman yüksek maliyet yaratmaz, ancak gereksiz uzun yanıtları teşvik eden bir tasarımın işareti olabilir. Görev için beklenen uzunluğu belirleyin: sınıflandırma birkaç kelime, ayrıntılı teknik açıklama daha uzun olabilir. Aynı modeli bütün görevlerde aynı sınırla kullanmak yerine görev türüne göre hedef koyun. Yanıt biçimini doğrulayın; yarım kalan bir JSON çıktısı işlem zincirini bozabilir.
Token kullanımını azaltmak için talimatı aşırı kısaltmayın. Güvenlik sınırları, kaynak gösterimi ve kullanıcıya belirsizliği anlatma kuralları korunmalıdır. Gereksiz tekrarları temizleyin, farklı görevlerin promptlarını ayırın ve test edin. Özellikle araç tanımları büyüdüğünde, kullanıcının görevine hiç uymayan araçları isteğe eklememek yararlı olabilir. Araçların erişim yetkisi ayrıca uygulama tarafında sınırlanmalıdır; token tasarrufu güvenlik tasarımının yerine geçmez.
Farklı diller ve içerik türleri
Türkçe, İngilizce ve kod içeren isteklerin token dağılımı farklı olabilir. Çok dilli bir sitede yalnızca İngilizce örneklerle bütçe belirlemeyin. Gerçek kullanıcı mesajlarından kişisel bilgileri temizleyerek küçük örneklem alın. Uzun ürün adları, bağlantılar, emoji ve biçimlendirme işaretleri de örneklerde yer alsın. Bir model yükseltmesinde tokenlaştırma değişebilir; aynı metnin sayımını yeniden yapın. Bütçeyi sabit karakter sayısına göre değil gerçek model ve istek biçimine göre yönetin.
Son olarak aylık maliyet raporunda toplam tokenın yanında görev başına kaliteyi gösterin. Bir işlem daha az token kullanıyor ama yanlış yanıt oranı artıyorsa optimizasyon başarısızdır. Tersine daha iyi belge seçimi hem maliyeti düşürüp hem doğruluğu yükseltebilir. Teknik ekibin, içerik ekibinin ve ürün sahibinin aynı değerlendirme örneklerini görmesi kararları şeffaflaştırır.
Sonuç
Tokenization, yapay zeka dil modellerinin metni anlamlandırmasının ilk ve en temel adımı. Bu mekanizmayı anlamak; hem API maliyetlerini daha isabetli tahmin etmenizi hem de bağlam penceresi sınırlarını aşmadan daha verimli promptlar tasarlamanızı sağlıyor. Özellikle Türkçe içerik üreten projelerde token verimliliğine dikkat etmek, uzun vadede belirgin bir maliyet farkı yaratabilir.
Sık Sorulan Sorular
Tokenization nedir, kısaca nasıl özetlenir?
Tokenization, bir metnin yapay zeka modelinin işleyebileceği küçük birimlere (token) bölünmesi işlemidir; bu birimler kelime, hece veya karakter olabilir.
1 token kaç karaktere denk gelir?
İngilizce metinlerde ortalama 1 token yaklaşık 4 karaktere denk gelir; Türkçe gibi eklemeli dillerde bu oran değişkenlik gösterebilir ve genellikle daha fazla token gerekebilir.
Token sayısını API isteği göndermeden nasıl öğrenebilirim?
OpenAI’nin resmi tokenizer aracı veya tiktoken gibi kütüphaneler kullanılarak metnin token sayısı gerçek bir istek göndermeden hesaplanabilir.
Bağlam penceresi (context window) ile tokenization arasındaki ilişki nedir?
Bağlam penceresi, bir modelin tek seferde işleyebileceği maksimum token sayısını ifade eder; prompt, geçmiş mesajlar ve yanıt bu sınıra dahil edilerek token cinsinden hesaplanır.
Türkçe metinler neden daha fazla token tüketir?
Çoğu modelin tokenizer’ı İngilizce ağırlıklı verilerle eğitildiği için Türkçe’nin eklemeli yapısı kelimelerin daha sık parçalara bölünmesine yol açar, bu da token sayısını artırır.
cl100k_base örneği yalnız bu encoding’in ham metin sayısını verir; bütün OpenAI, Claude veya Gemini modellerinin gerçek faturalandırmasını hesaplamaz. Hedef modele ait tokenizer’ı seçin, mesaj/araç ek yükünü ve yanıtın usage alanını kontrol edin. Token embedding’i ile bir belgenin aramada kullanılan sentence/document embedding’i farklı düzeylerdir; vektör veritabanı genellikle ikinci türü saklar. Türkçe/İngilizce maliyet oranı için aynı anlamdaki kendi örneklerinizi ölçün; sabit yüzde kullanmayın.
Kaynak: OpenAI — tiktoken.